⏱️ 10 min de leitura
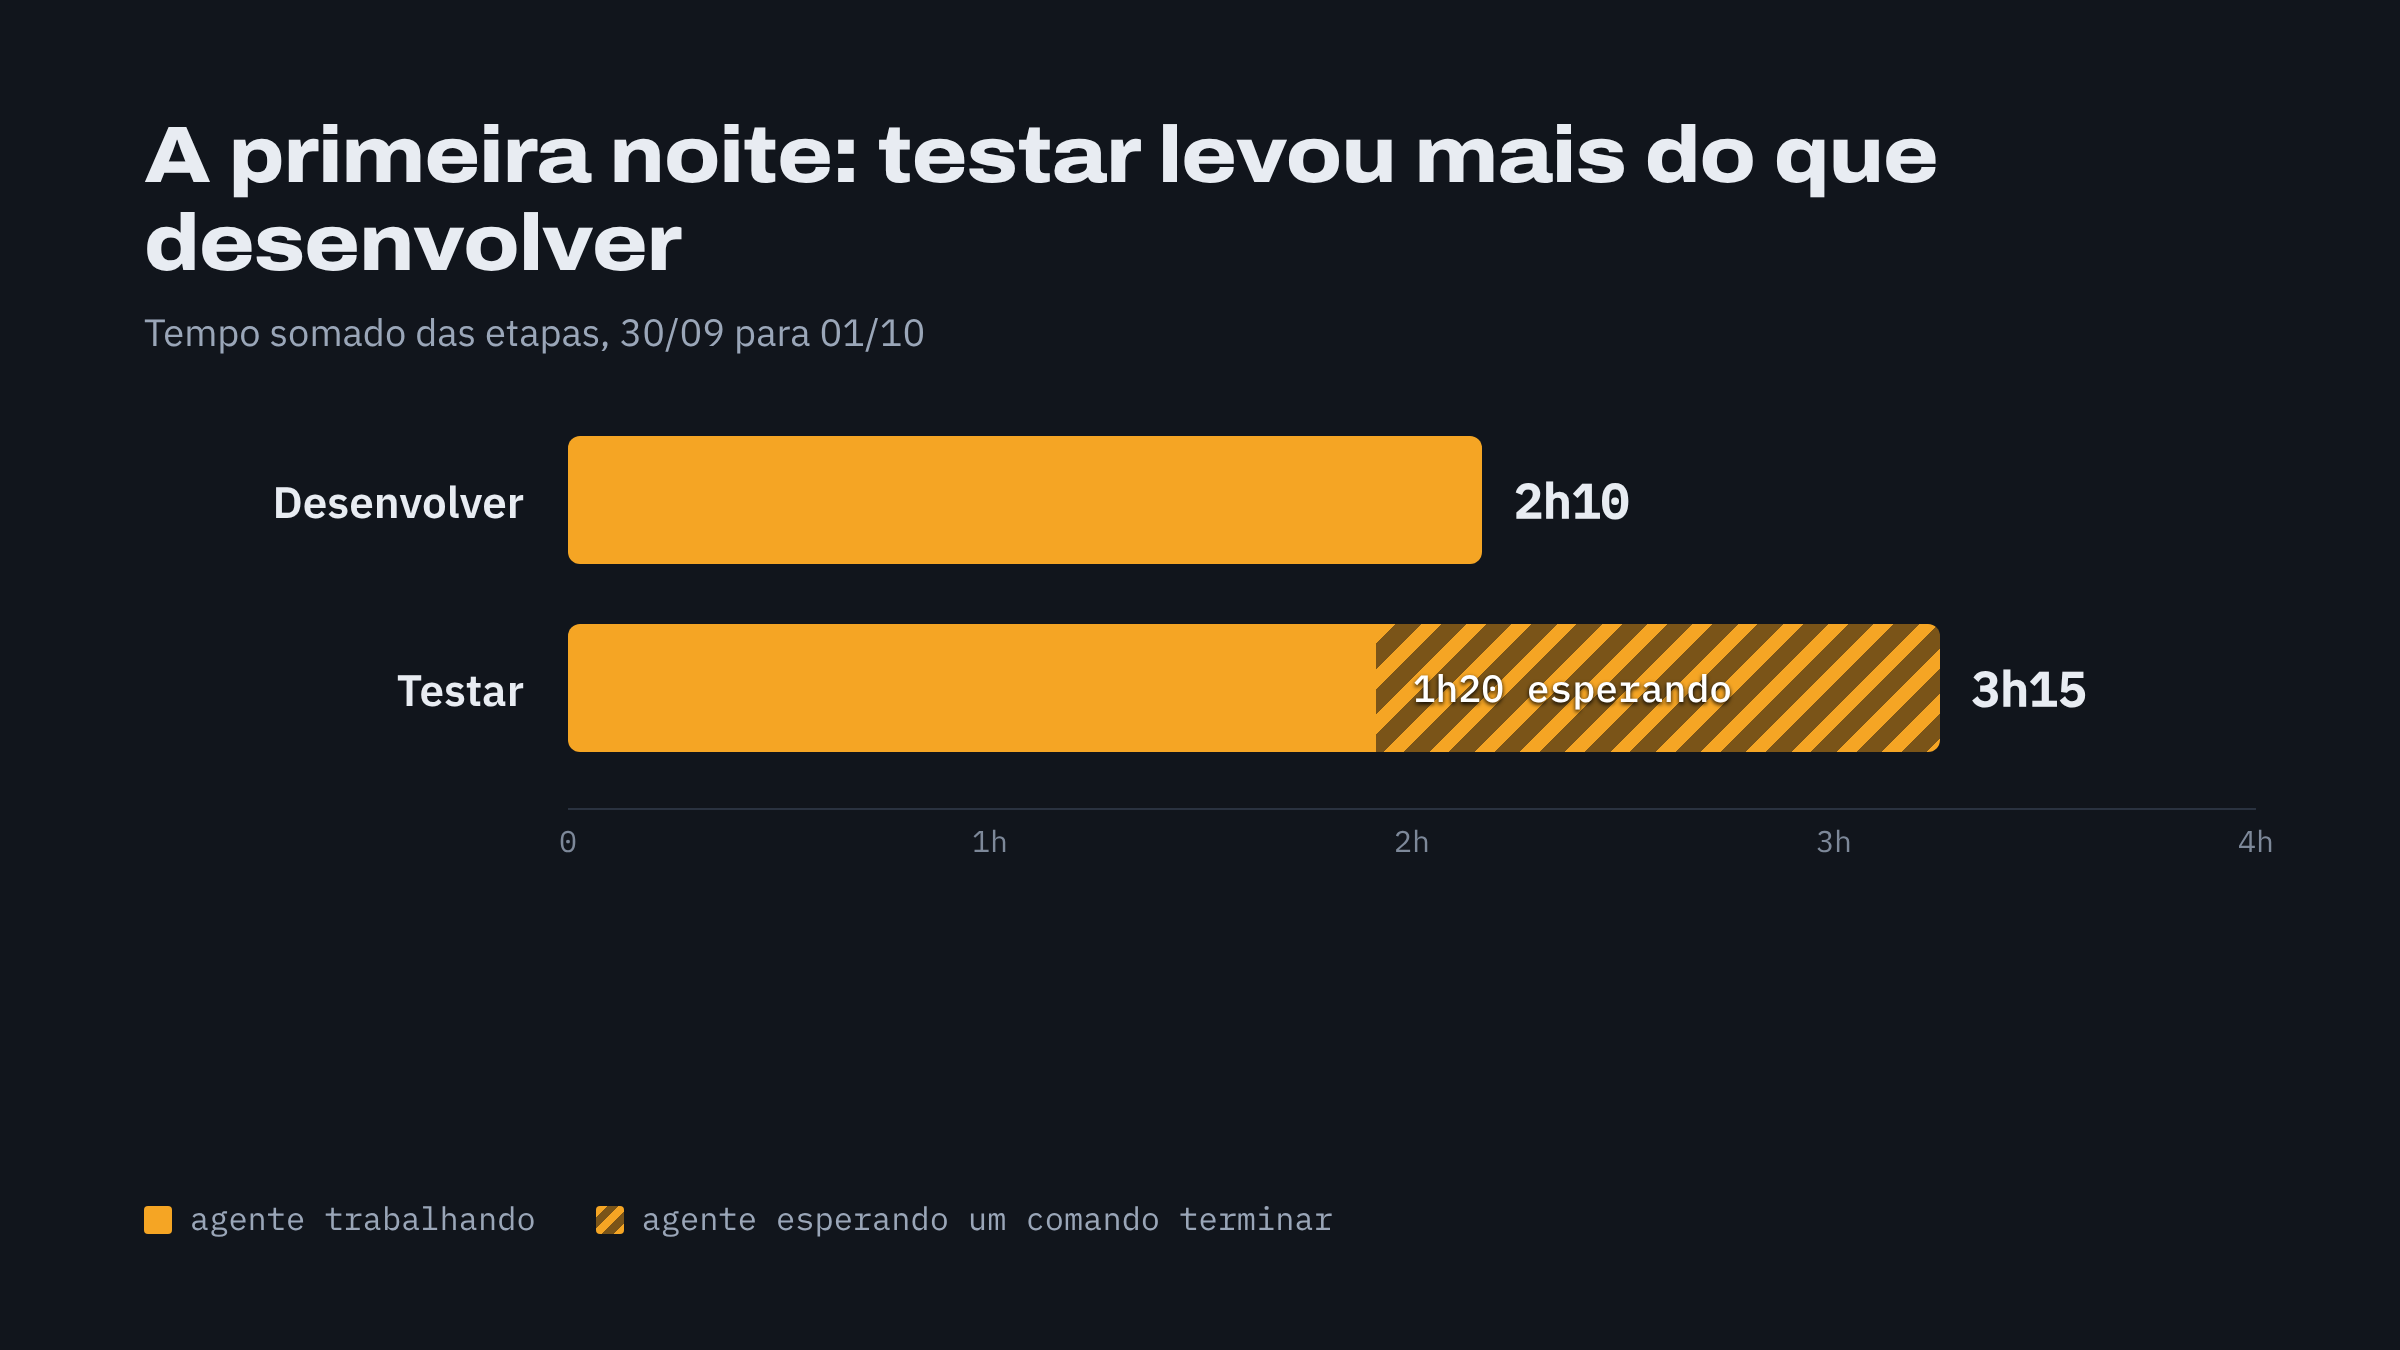
No capítulo anterior, a fábrica passou a primeira noite inteira trabalhando sem mim. Acordei com 10 tarefas entregues, testadas e integradas. Mas, quando somei o tempo das etapas daquela noite, uma conta não fechava. Testar levou mais do que desenvolver: cerca de 3h15 contra 2h10. E 1h20 desse teste foi um agente esperando um comando terminar.
A pista já estava no capítulo 1, Escala 6x1? Aqui é 24x7: a segunda execução real levou quase 40 minutos, com a integração contínua rodando quatro vezes até passar. Na hora, eu achei que era coisa de começo. Era o padrão.
Este capítulo é sobre essa conta: por que escrever código deixou de ser a parte cara do trabalho, e o que eu mudei para as noites seguintes não gastarem o relógio esperando.
Onde o tempo ia
Quando olhei para dentro das execuções, a surpresa não foi o teste demorar. Foi onde o tempo ia.
Antes, uma legenda para o resto do capítulo:
- ⚙️ Motor: o orquestrador da fábrica que apresentei no capítulo 1. Um programa comum, determinístico, sem IA, que faz sempre a mesma coisa do mesmo jeito.
- 🤖 Agente: uma IA fazendo o trabalho.
Rodar um teste é barato. Um comando roda a suíte, ela passa ou falha, e acabou. O caro era tudo o que acontecia em volta, quando quem testa é uma IA:
- 🤖 Ler: o agente de testes lia registros de execução inteiros, alguns com centenas de kilobytes, para descobrir o que tinha falhado.
- 🤖 Esperar: ele disparava um comando longo e ficava consultando se tinha terminado, dentro do próprio turno, com condições de espera que às vezes nunca se cumpriam.
- 🤖 Reler: a cada turno, ele relia o contexto inteiro da tarefa.
Não é só o contexto, é o turno
Eu jurava que a segunda noite tinha ficado mais lenta porque cinco execuções disputavam o processador. Quando a IA cruzou os números, deu outra coisa: a suíte levava até um pouco menos que na primeira noite. O que tinha crescido era o número de turnos do agente de testes, que passou de 400 em uma só execução.
Quando se fala em economizar com IA, quase todo mundo pensa no contexto: o quanto de texto entra na conversa. Só que o modelo relê o contexto inteiro a cada turno. Toda vez que o agente roda um comando, lê um arquivo ou confere um resultado, é mais uma leitura de tudo. Uma conta simples mostra o tamanho disso:
- 500 mil tokens de contexto, 5 turnos: o modelo lê cerca de 2,5 milhões de tokens na sessão.
- 250 mil tokens de contexto, 20 turnos: metade do contexto, e cerca de 5 milhões de tokens lidos. O dobro.
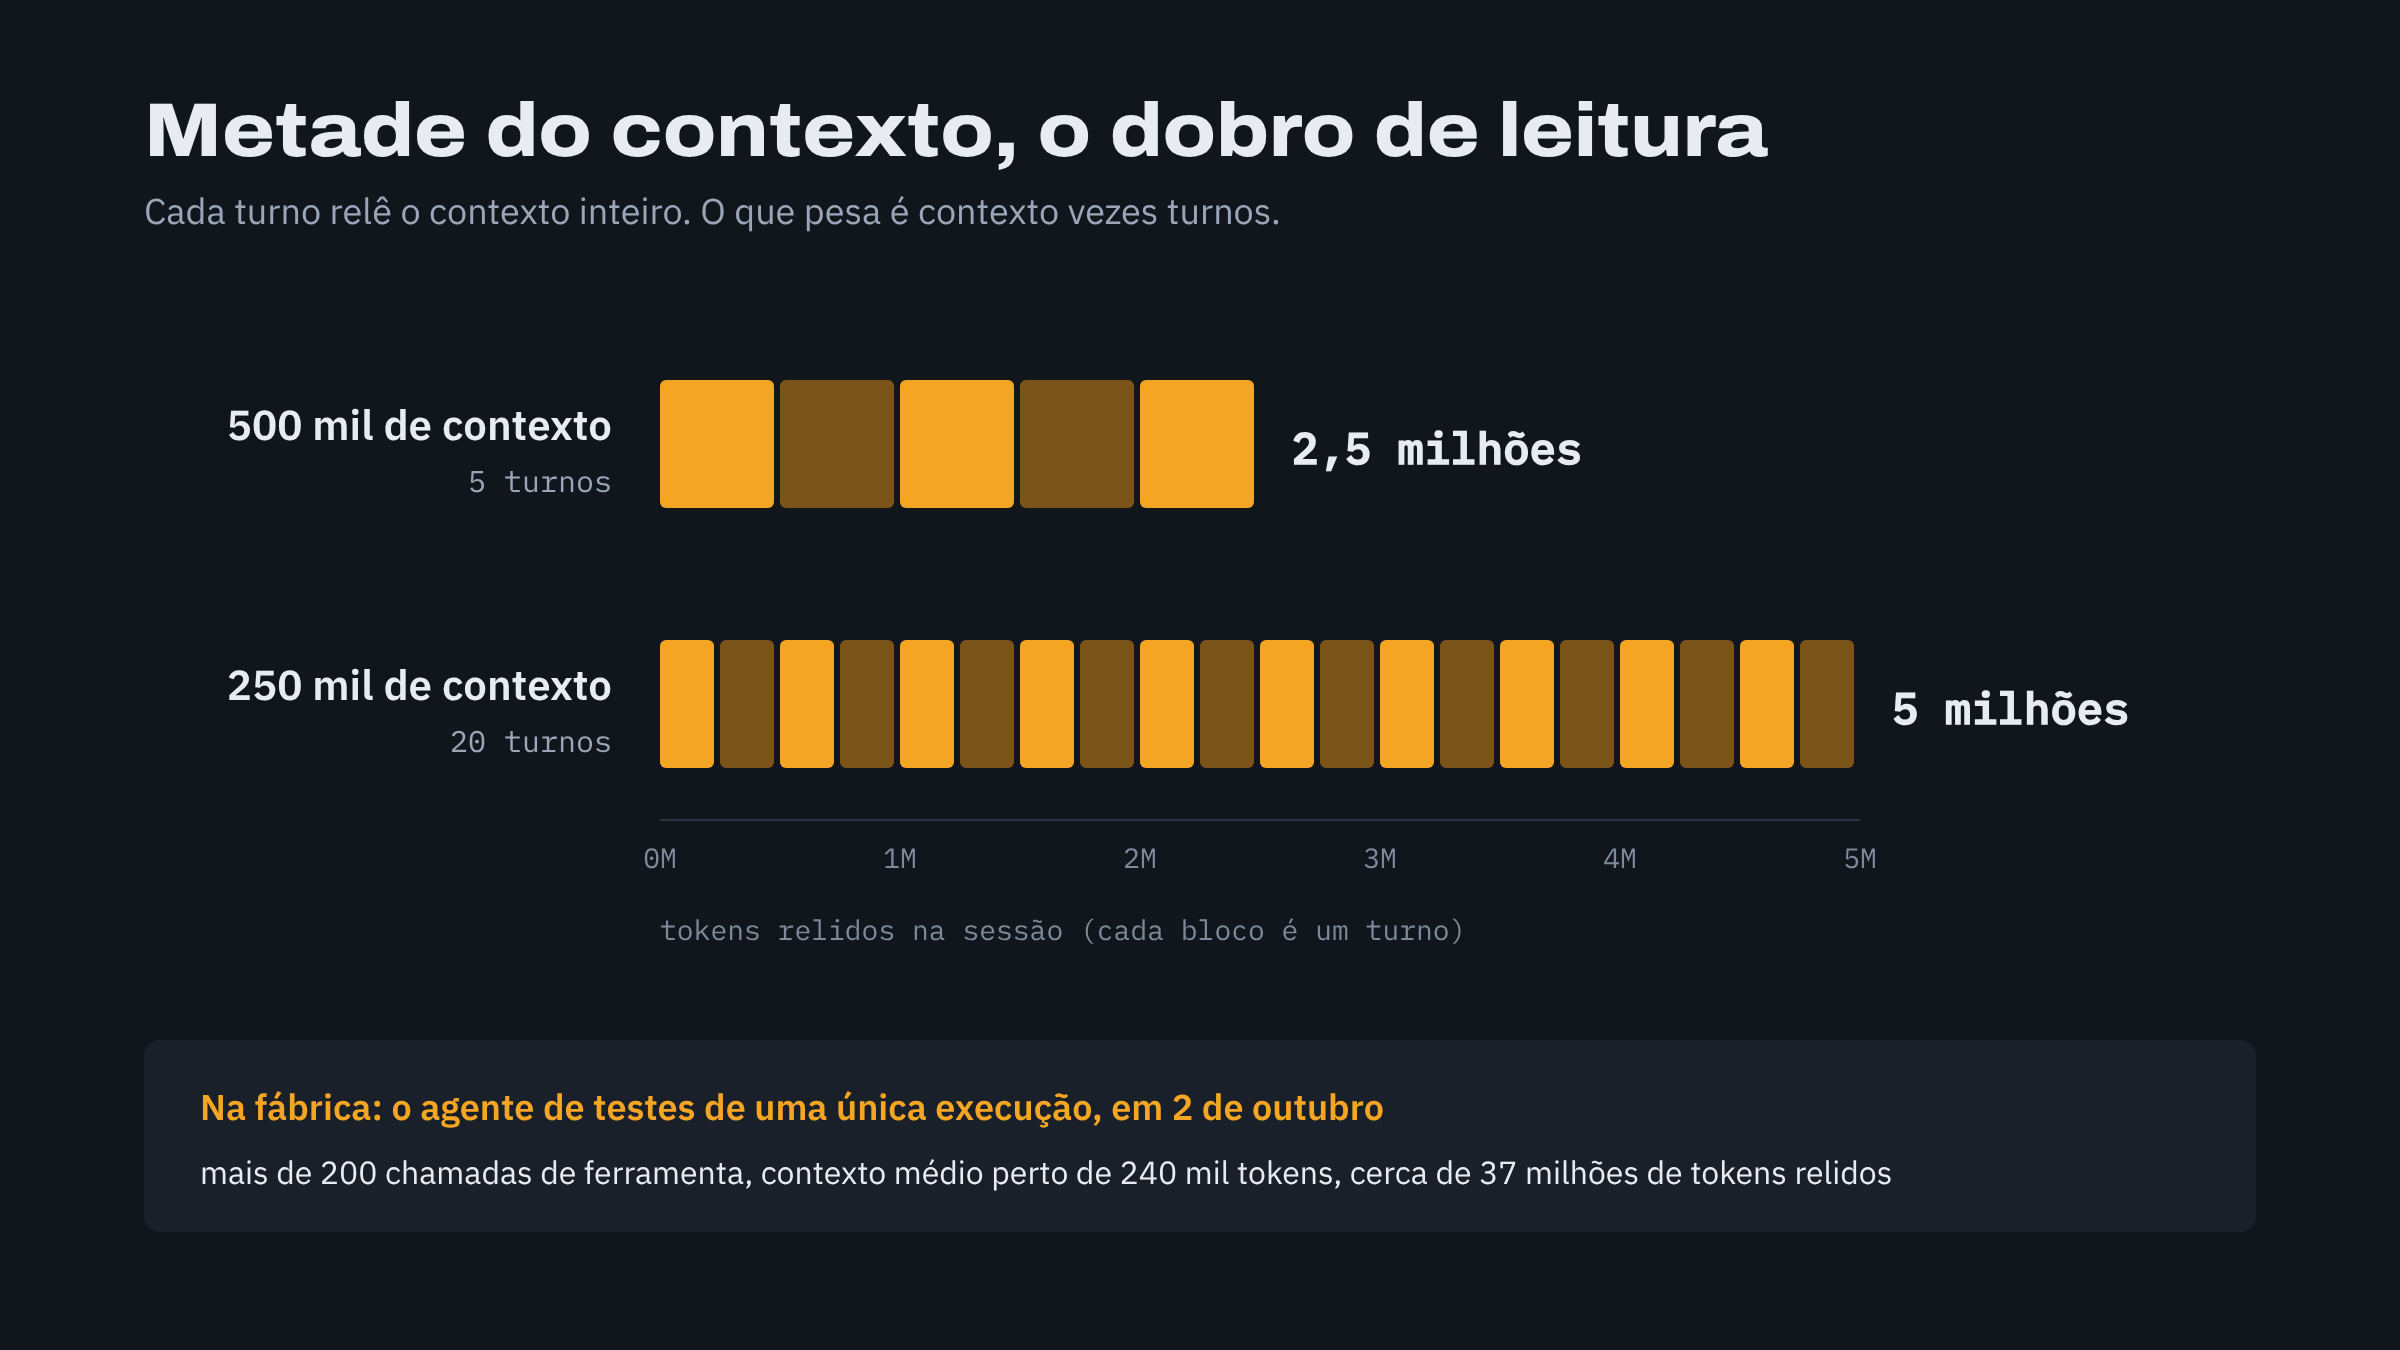
Na fábrica, os números eram bem maiores. Em uma execução de 2 de outubro, o agente de testes fez mais de 200 chamadas de ferramenta, com um contexto médio perto de 240 mil tokens. No fim, ele tinha relido cerca de 37 milhões de tokens, e essa releitura respondeu por cerca de três quartos do que ele custou.
Os provedores guardam por alguns minutos o que acabou de ser lido, e reler esse trecho custa uma fração de um token novo. Mas um agente que fica esperando um comando longo pode voltar com essa memória expirada e pagar a leitura inteira de novo.
Cuidar do que entra no contexto ajuda. Cuidar de quantas vezes ele é relido ajuda tanto quanto.
A pirâmide de cabeça para baixo
Quem trabalha com software conhece a pirâmide de testes. Na base, muitos testes unitários, pequenos, rápidos e baratos. No topo, poucos testes de ponta a ponta, que abrem o aplicativo e simulam um usuário, lentos e caros.
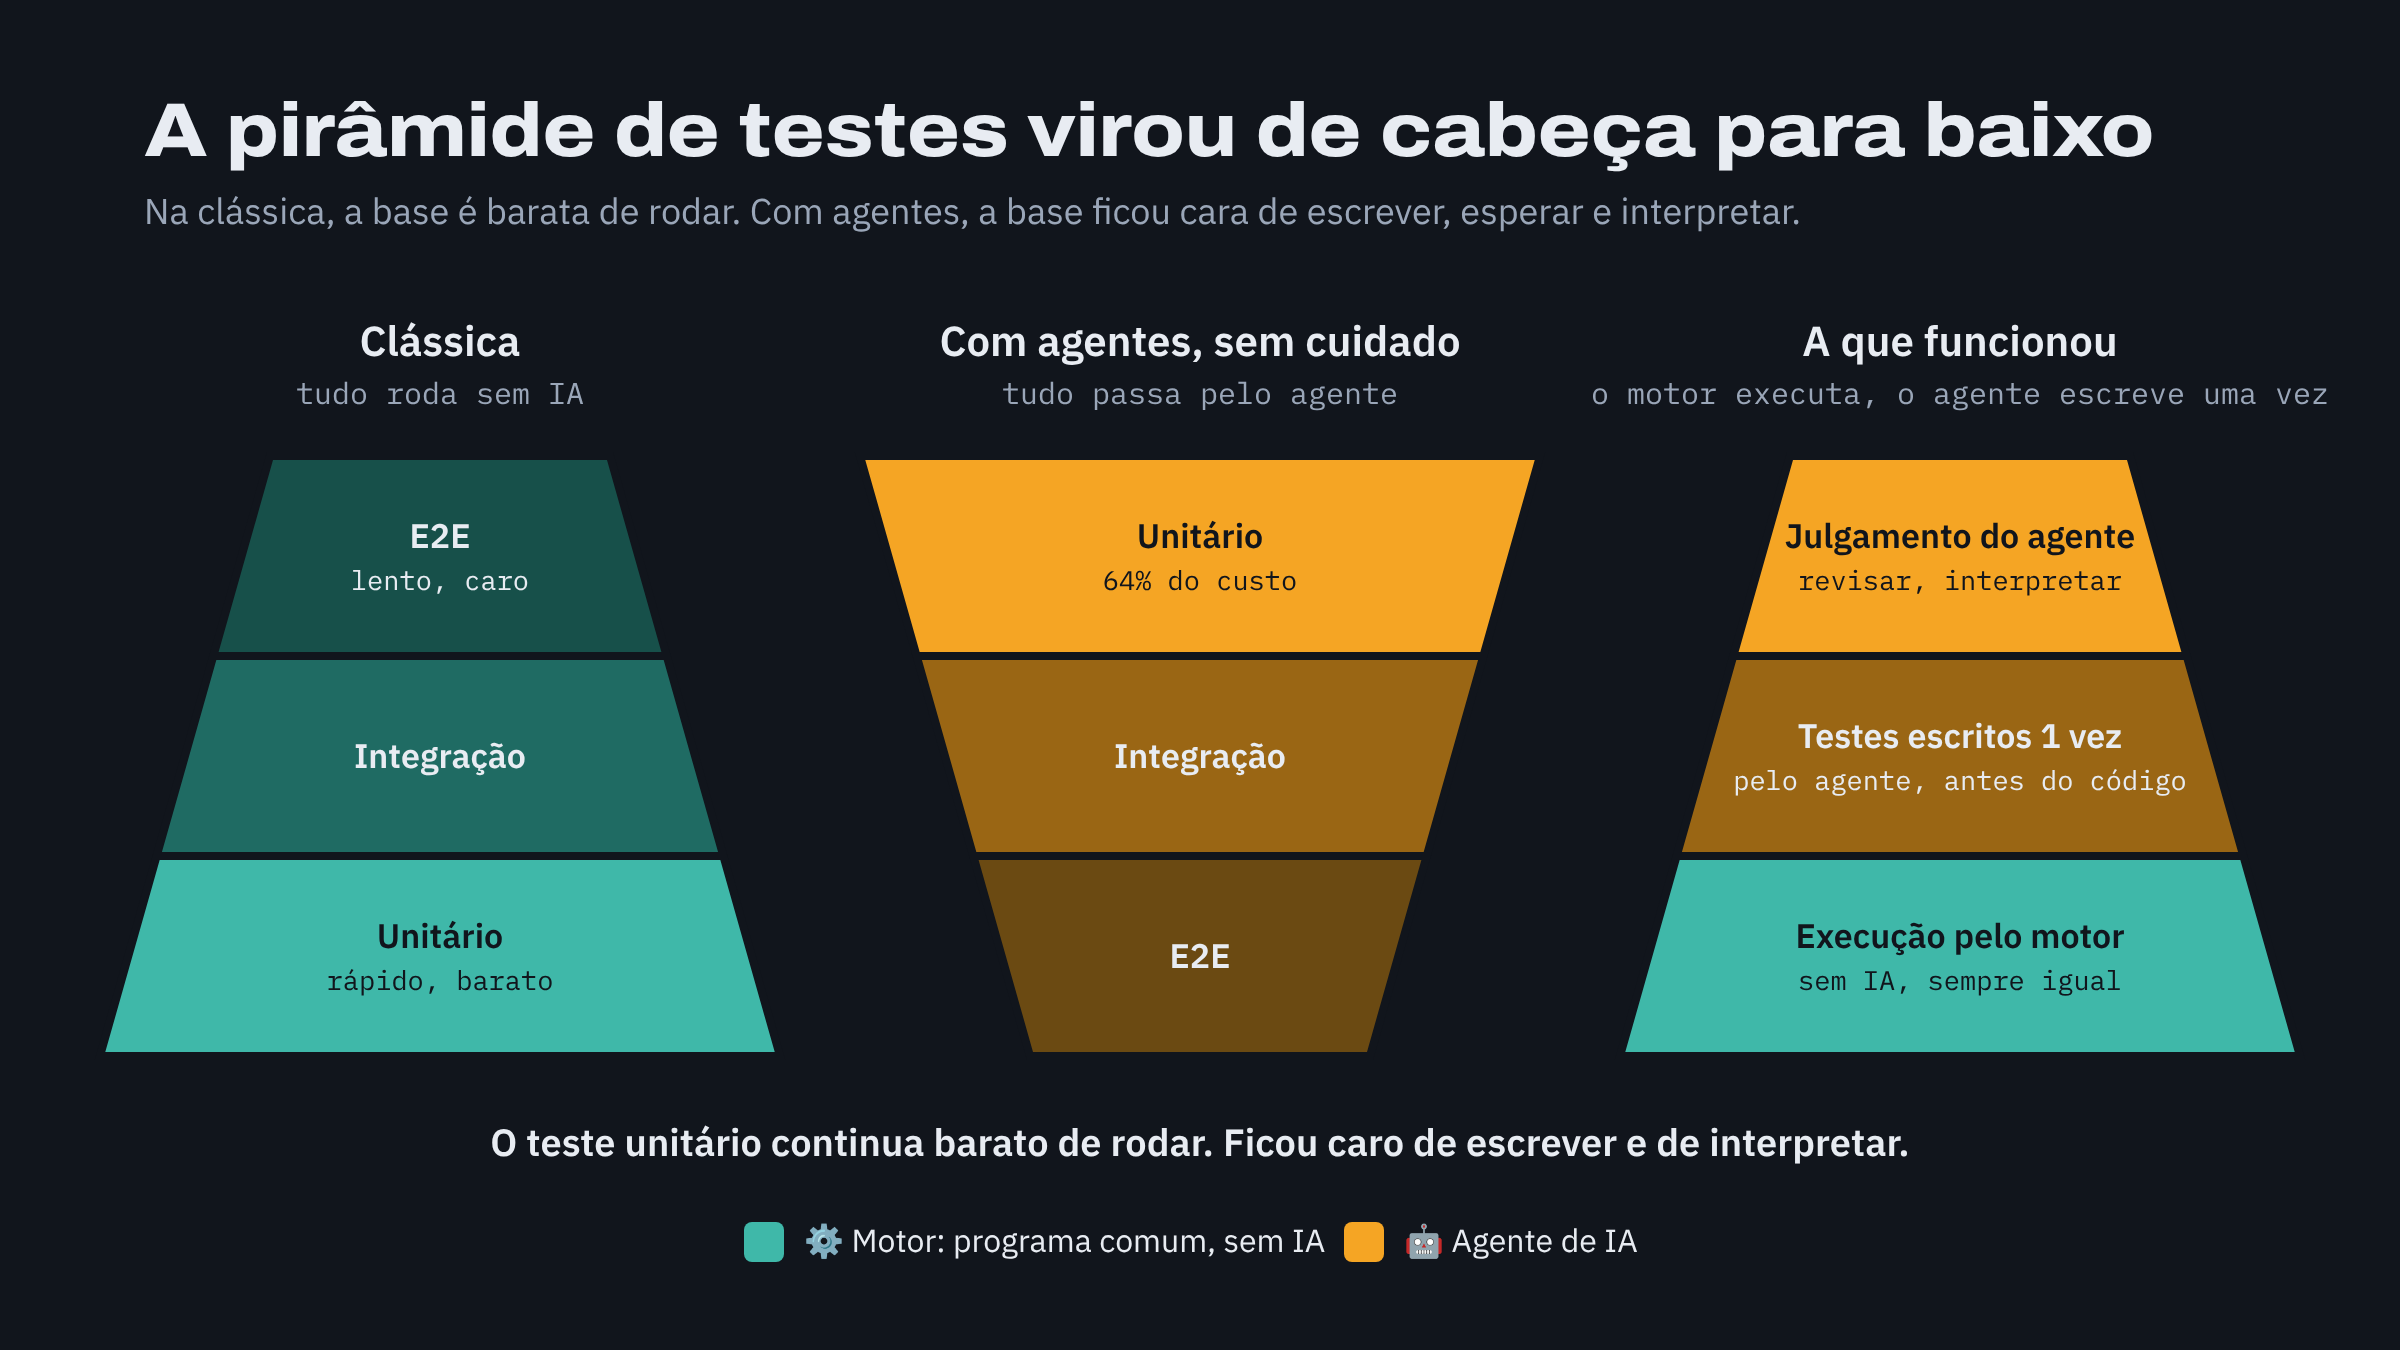
A pirâmide sempre foi ordenada pelo custo de executar o teste. Com agentes, o que manda é outro custo: o de escrever o teste, esperar por ele e interpretar o resultado, pago em tokens. E esse custo pesa mais justamente na base, que é onde ficam mais testes.
Os números confirmaram. O teste respondia por quase metade do custo de uma execução. Quando eu acrescentei os testes de comportamento, que descrevem o que o usuário faz na tela, passou de 60%. Em uma execução, o agente de testes sozinho ficou com cerca de dois terços do custo.
Também tentei o outro extremo e desliguei os testes em uma execução. Ela saiu barata e rápida, e deixou passar três regressões, coisas que funcionavam e pararam de funcionar.
O motor executa, o agente escreve uma vez
A resposta foi separar dois trabalhos que estavam misturados e gastar IA só onde existe uma decisão a tomar. O agente escreve o teste uma vez, e o motor roda sempre.
Tudo o que era execução saiu da mão do agente:
- ⚙️ Rodar a suíte: quem roda é o motor, e ele devolve ao agente só o resumo das falhas.
- ⚙️ Escolher os testes: os testes afetados por uma mudança saem do mapa de quem usa o quê no código, não de um palpite do agente.
- ⚙️ Falhas antigas: uma lista das falhas que já existiam na main, para a execução não levar a culpa por um erro que não é dela. Havia nove falhas assim sendo contadas na conta errada.
- ⚙️ Esperas: tempo limite, nova tentativa e espera ficam com o motor, fora do turno do agente.
- ⚙️ Ambiente fixo: a mesma suíte levava 29 minutos dentro do aplicativo e 6 a 7 no terminal, por causa de uma configuração herdada sem querer. Corrigido isso, ela caiu para cerca de 5 minutos.
- ⚙️ Teste pesado na versão: a suíte inteira, a regressão e os testes de ponta a ponta saíram de cada tarefa e foram para o fechamento de uma versão, em um corte que eu marco no roadmap.
O agente ficou com o que pede julgamento:
- 🤖 Decidir o que testar: a partir do critério de aceite.
- 🤖 Escrever o teste novo: uma vez, antes do código.
- 🤖 Entender uma falha: já resumida pelo motor.
A terceira noite: o custo despencou, o relógio não
A primeira noite com a ferramenta atualizada mostrou os dois lados da mudança.
O custo do teste por execução caiu para uma fração do que era, algo entre um quinto e um vigésimo. Em tokens, o problema estava resolvido.
No relógio, não. A suíte, agora rodada pelo motor, passou a levar cerca de 30 minutos por rodada, contra 4 a 11 antes. Foram quatro rodadas naquela noite, e três estouraram o tempo limite. Uma delas levou a execução até um ponto do fluxo em que só eu decido, e ela ficou parada esperando eu acordar. A automação não atravessou a minha aprovação, como deve ser. Mas aquela execução parou até de manhã.
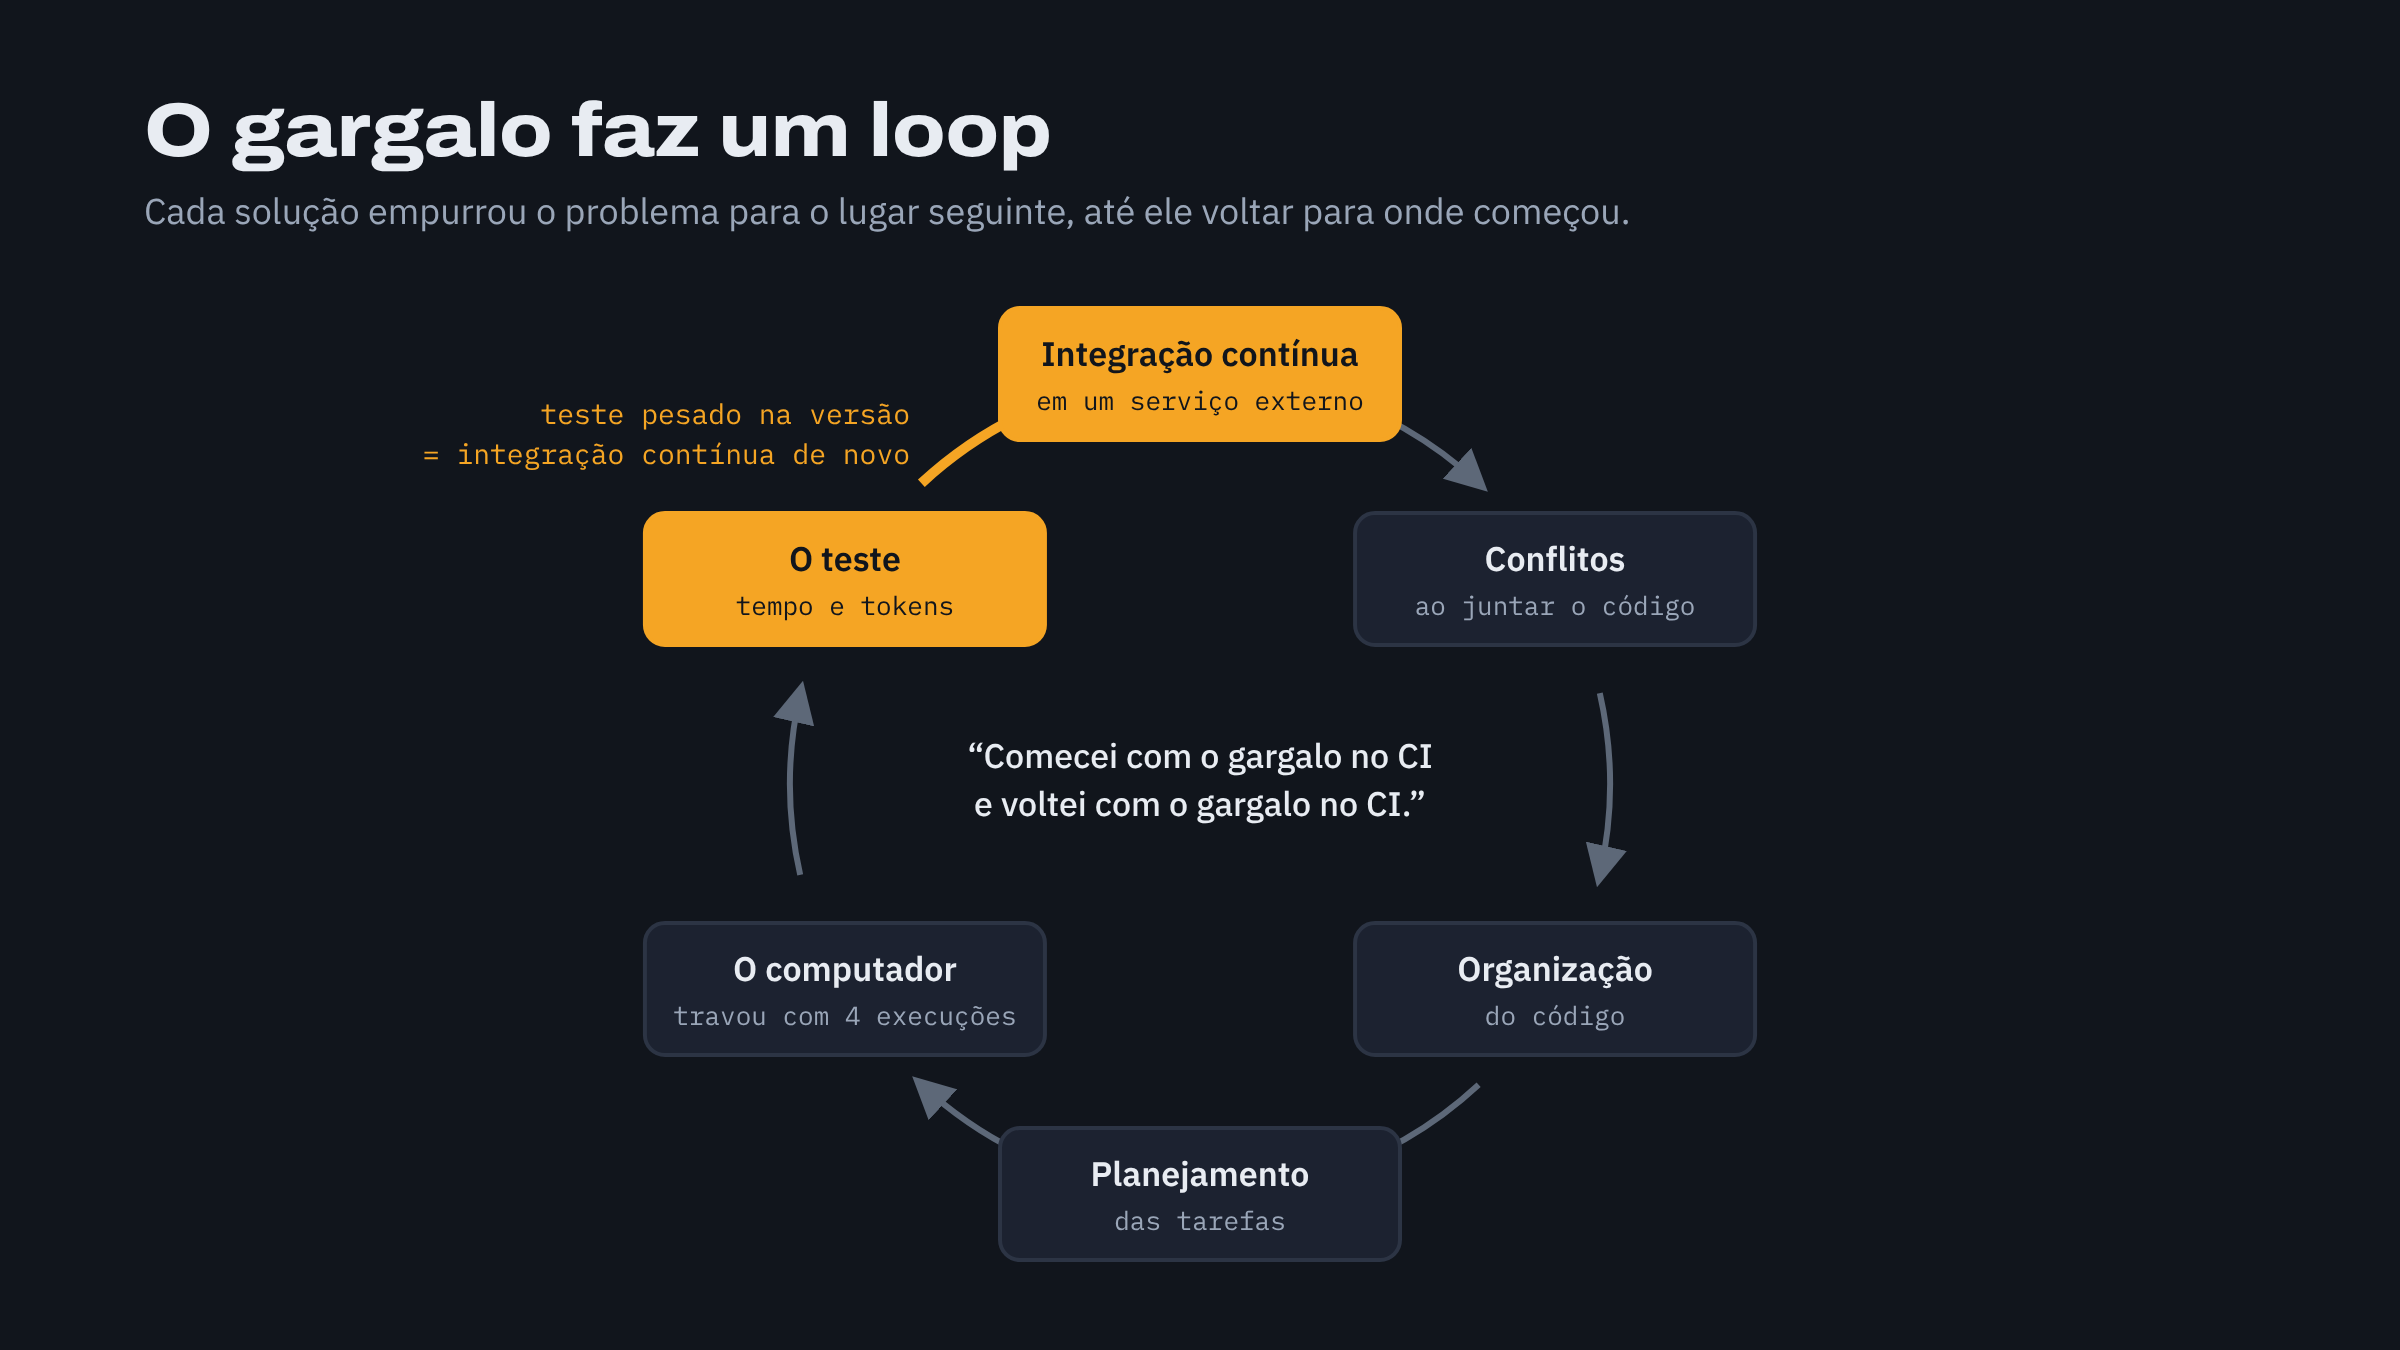
Levar o teste pesado para o fechamento de uma versão era, na prática, reconstruir a integração contínua de outro jeito. Na época, escrevi:
"Comecei com o gargalo no CI e voltei com o gargalo no CI. É engraçado como o gargalo faz um loop."
Testes antes do código
Faltava uma pergunta: quem escreve o teste?
Desde o começo, a regra era que o agente que desenvolve nunca escreve os próprios testes, para não testar o próprio viés. Só que o agente de testes vinha depois do desenvolvimento e lia o código pronto. Pagava a conta de reler tudo e, mesmo assim, escrevia os testes a partir do que o código fazia, e não do que a tarefa pedia.
Então inverti a ordem em um fluxo novo de desenvolvimento. Com o exemplo do aplicativo de tarefas (To Do) do capítulo 2, o pedido "quero adicionar uma data prevista nas tarefas" passa a andar assim:
- 🤖 Teste primeiro: o agente de testes lê a tarefa e os critérios de aceite, não o código. Cada critério ganha pelo menos um teste: a tarefa grava a data prevista, o card mostra a data, uma tarefa sem data continua funcionando. Ele olha só as partes públicas que os critérios citam, como a tela do card e a função que grava a tarefa, e nunca o miolo que a mudança vai reescrever. Os testes vão para a cópia isolada antes de qualquer linha de código, e uma trava impede o desenvolvedor de editá-los.
- 🤖 O que não dá para testar fica escrito: um critério que não dá para verificar automaticamente, como um detalhe visual ou uma medida, vai para uma lista própria, com o motivo. Nada de teste de mentira para cobrir o critério.
- ⚙️ Prova de que falha: antes de qualquer código, o motor roda só os testes novos, uma vez. Eles têm que falhar porque a data prevista ainda não existe, e não por um erro de digitação no próprio teste. Um teste que já passa volta marcado para o desenvolvedor: ou ele protege algo que já funcionava, ou está errado. Um arquivo de teste que nem roda volta para quem o escreveu.
- 🤖 Desenvolver até passar: o desenvolvedor implementa até os testes passarem. Junto com os testes, ele recebe a lista dos testes que já existem e cobrem os arquivos que vai mexer, tirada do mapa do código. Quando quer rodar os testes, ele pede, e quem roda é o motor, que devolve só o que falhou.
- 🤖⚙️ Na tela também: nos testes de ponta a ponta, até três cenários por tarefa são escritos primeiro, no formato dado, quando, então: "dada uma tarefa com data prevista, quando eu abro a lista, então vejo a data no card". O agente escreve os cenários, o motor roda cada passo, e um agente consertador só entra quando um cenário falha.
A quarta noite
Na noite seguinte, o fluxo novo rodou de verdade:
- 10 execuções de 10, todas com sucesso.
- 19 tarefas entregues.
- A checagem de que os testes falham pelo motivo certo passou limpa de primeira em 11 de 11.
- Os testes de ponta a ponta pegaram três defeitos reais que os unitários não pegavam. Um deles: uma tela que deslizava quase 500 pixels para o lado.
- O consertador acertou nos dois sentidos. Duas vezes concluiu que o defeito estava no aplicativo e não mexeu no teste. Duas vezes corrigiu o próprio teste sem mudar o que ele verificava.
Uma coisa não mudou: o revisor encontrou problemas graves em 7 das 10 execuções. Os testes não substituíram a revisão, e a revisão não substituiu os testes.
Teve desperdício, claro. Duas vezes o desenvolvedor esqueceu de colocar nos elementos da tela o data-testid, a marcação que os cenários usam para achar cada botão, campo ou card. Sem ela, o teste não encontra o elemento e falha. Uma rodada inteira da suíte foi jogada fora em cada uma. A correção é barata, e é trabalho do motor ⚙️: conferir se cada data-testid que os cenários pedem existe na tela antes de rodar a suíte.
O gargalo andou de novo
Não era a primeira vez que o gargalo mudava de lugar. Ele começou na integração contínua, que rodava em um serviço externo. Depois foi para os conflitos na hora de juntar o código, para a forma como o código estava organizado, para o planejamento, para o próprio computador, que travou com quatro execuções pesadas ao mesmo tempo, e voltou para o teste.
Resolvido o teste, ele andou mais uma vez. Comparado com o fluxo anterior, o novo cortou um terço dos tokens por tarefa. O agente de testes, que ficava com quase metade dos tokens, passou a ficar com pouco mais de um décimo. Agora era o desenvolvedor que ficava com três quartos, e mais da metade das execuções voltava para ele pelo menos uma vez para corrigir alguma coisa.
A próxima economia está nessas voltas: testes de aceite mais claros e checagens baratas antes da suíte valem mais do que trocar o modelo de IA.
O próximo passo
Aquela 1h20 de um agente esperando um comando terminar não era só um problema de teste. A execução mais cara do projeto inteiro não entregou nada: um agente passou o tempo perguntando, de novo e de novo, se algo tinha terminado.
No próximo capítulo, capítulo 5, O token mais caro é o de uma IA esperando, conto essa execução e a regra que nasceu dela: esperar é trabalho de código.