⏱️ 8 min de leitura
No capítulo anterior, O gargalo não é o código, é o teste, a primeira noite inteira da fábrica escondia uma conta estranha: 1h20 do teste foi um agente esperando um comando terminar. Resolvido o teste, sobrou uma pergunta maior. Por que uma IA estava esperando, para começo de conversa?
A resposta estava em uma execução de dias antes, a mais cara do projeto inteiro. Ela não entregou nada.
Este capítulo é sobre essa execução, sobre a regra que eu tirei dela na mesma noite e sobre um jeito de esperar que eu não sabia que existia.
16h37: a primeira tarefa que a fábrica pegou sozinha
Era a terça-feira do capítulo 2, O dia em que a IA saiu do meu volante. Às 15h46, eu tinha aberto uma sessão só para anotar o backlog. Às 16h37, a ferramenta tirou dali a primeira tarefa e começou a trabalhar nela sozinha: uma tela para acompanhar, ao vivo, o que cada execução estava fazendo.
Antes de seguir, a legenda que vale para o resto do capítulo, a mesma do capítulo 4:
- ⚙️ Motor: o orquestrador da fábrica. Um programa comum, determinístico, sem IA, que faz sempre a mesma coisa do mesmo jeito.
- 🤖 Agente: uma IA fazendo o trabalho.
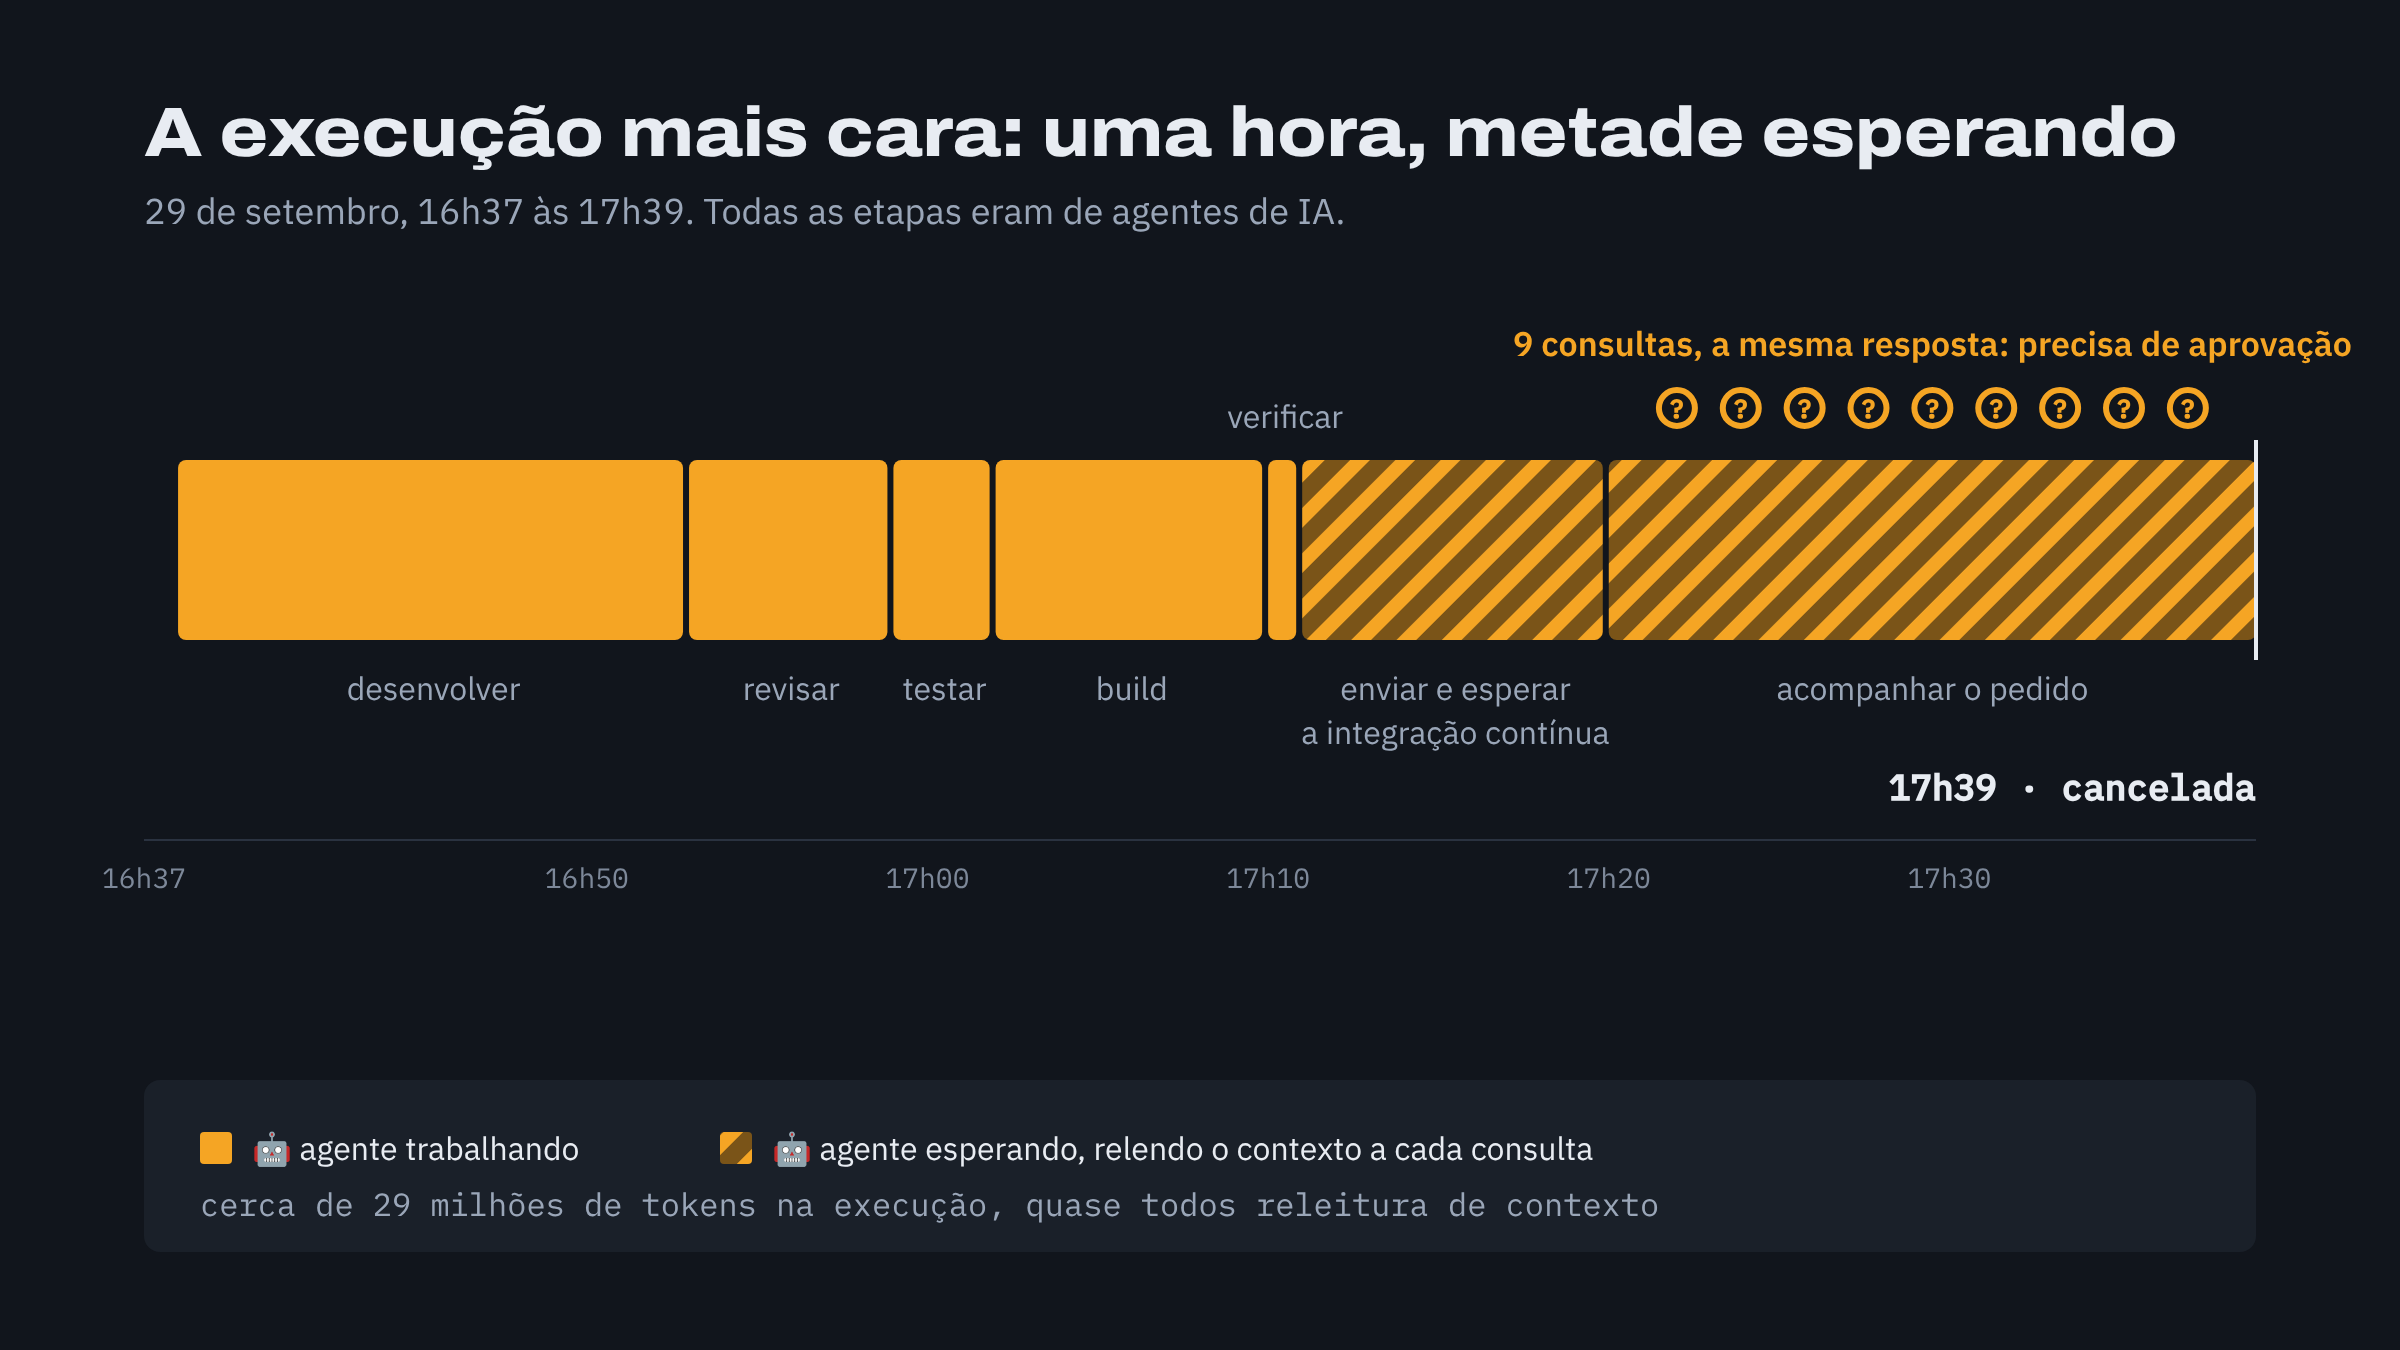
O começo foi o de sempre. O agente desenvolveu por cerca de 20 minutos, outro revisou, um terceiro escreveu os testes. O build travou algumas vezes, porque uma cópia esquecida do aplicativo segurava um arquivo aberto, mas passou. A verificação passou. Às 17h11, a tarefa chegou nas duas últimas etapas, as que cuidam do código depois que ele sai da fábrica:
- 🤖 Enviar: um agente manda o código para o GitHub, abre o pedido para juntá-lo à main e espera a integração contínua.
- 🤖 Acompanhar: outro agente fica de olho nesse pedido até ele ser integrado, respondendo ao que aparecer no caminho.
Foi aí que a execução parou de andar e continuou gastando.
Nove vezes a mesma pergunta
O agente que acompanhava o pedido precisava de uma ferramenta de linha de comando do GitHub para ler o estado dele. Essa ferramenta estava fora da lista do que ele podia rodar sem a minha permissão.
Então ele perguntou. A resposta foi a mesma: precisa de aprovação. Ele esperou e perguntou de novo, e de novo. Em um certo ponto, ele mesmo registrou que já tinha pedido acesso uma vez, que o pedido tinha sido ignorado e que não ia pedir de novo. E continuou consultando.
Foram nove consultas, todas com a mesma resposta. O fluxo dizia para ele conferir o pedido a cada minuto, por até 12 horas. Se eu não tivesse cancelado, seriam 12 horas de uma IA perguntando se uma porta trancada tinha aberto sozinha.
O agente de antes, o que enviava o código, já tinha passado por algo parecido. Ele queimou cerca de 15 tentativas recusadas até achar o jeito de chamar a mesma ferramenta que a lista permitia. E quem esperava a integração contínua também era ele, consultando, de turno em turno.
Às 17h39 eu cancelei. No registro, o resultado da execução é um só: cancelada.
A conta da espera
Quando fui olhar o que ela custou, os números contaram a mesma história do capítulo 4, só que mais alta:
- Cerca de 1 hora de execução, das 16h37 às 17h39.
- Cerca de 29 milhões de tokens, e quase todos eram releitura do contexto.
- 9 consultas ao mesmo pedido, com a mesma resposta.
- Cerca de 15 tentativas recusadas até achar o jeito permitido de chamar a ferramenta.
- Cerca de 900 mil tokens gastos só esperando a integração contínua.
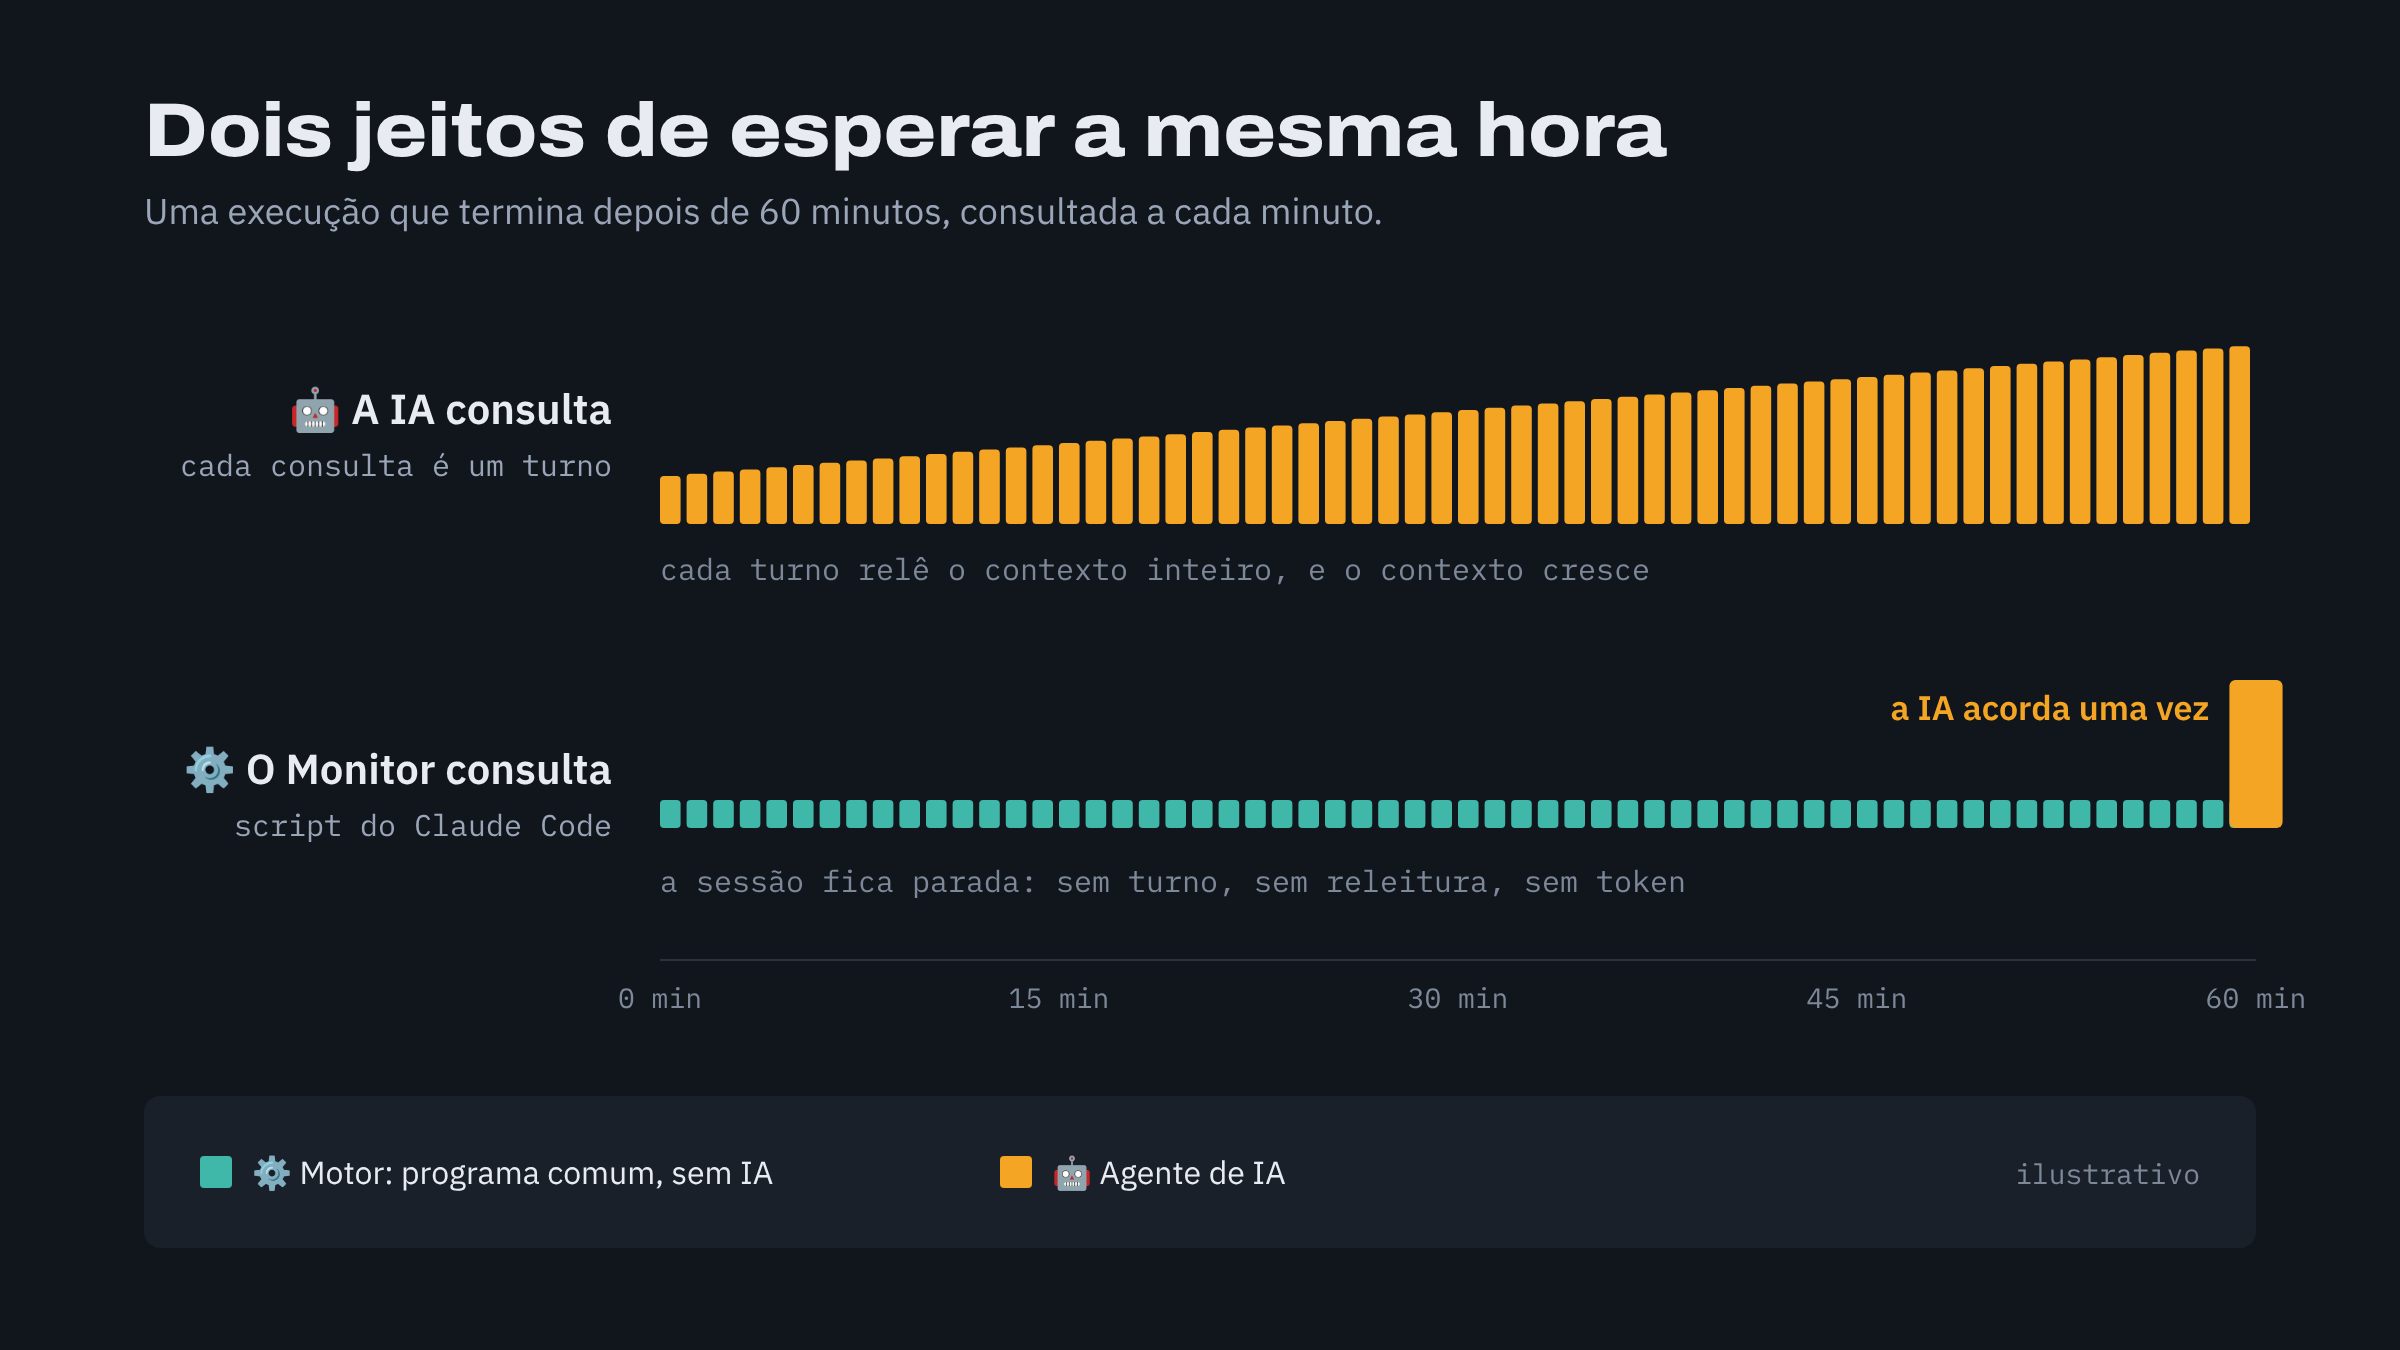
A releitura é o detalhe que importa. No capítulo 4, eu contei que o modelo relê o contexto inteiro a cada turno. Uma consulta que só pergunta "já terminou?" parece barata. Para uma IA, cada uma dessas perguntas é uma leitura da tarefa inteira, com tudo o que ela já fez até ali. Quanto mais longa a tarefa, mais cara fica a mesma pergunta.
Uma pessoa esperando um build termina de esperar e pronto. Uma IA esperando paga para lembrar do que estava fazendo, toda vez que olha o relógio.
A regra, na mesma noite
O cancelamento foi às 17h39. As correções vieram no mesmo dia, pela própria fábrica.
Às 18h04, a primeira. Uma espera que recebe três vezes seguidas a mesma resposta de "bloqueado" para de esperar e avisa. O tempo máximo de acompanhamento caiu de 12 para 4 horas, e a consulta passou a ser de 2 em 2 minutos. E, quando um agente tem várias chamadas recusadas em sequência, isso aparece como alerta, em vez de virar silêncio caro.
Às 20h17, a segunda, que é a que mudou o desenho. Quem espera a integração contínua deixou de ser a IA. O motor passou a consultar o GitHub sozinho, no relógio dele, e a chamar o agente só quando existe um resultado. O agente que envia o código também passou para um modelo mais barato, porque o que sobrou para ele fazer pedia menos.
Na primeira execução depois disso, às 20h33, o motor consultou a integração contínua quatro vezes. O agente foi chamado uma.
A regra ficou assim:
- ⚙️ Esperar: o motor consulta o status, o build, a integração contínua, no relógio dele e sem IA.
- ⚙️ Desistir: a mesma resposta três vezes seguidas encerra a espera e chama alguém.
- 🤖 Decidir: o agente só entra quando chega algo que pede julgamento. O teste falhou, o código conflitou, a revisão achou um problema.
É a mesma divisão que o capítulo 4 fez com o teste: o motor executa, o agente julga. A diferença é que, aqui, eu só percebi depois de pagar a conta mais alta do projeto.
"Cancela o monitor"
Naquela mesma semana, na noite que contei no capítulo 3, Dormi e acordei com o trabalho pronto, a minha última mensagem antes de dormir foi esta:
"Cancela o monitor, vou dormir e deixar o PC rodando."
O monitor era o Claude acompanhando as execuções por mim. Ele olhava, de tempos em tempos, se alguma coisa tinha terminado ou quebrado. Era exatamente o agente das nove consultas, só que do meu lado da mesa. Cancelei porque não fazia sentido pagar uma IA para olhar outra IA trabalhar enquanto eu dormia.
Só que eu ainda queria alguém olhando. E foi aí que eu descobri que o problema já tinha uma solução pronta, dentro do próprio Claude Code.
O Monitor que não gasta token
O Claude Code tem um recurso chamado Monitor, que eu não conhecia. O nome é o mesmo do que eu tinha cancelado, mas o jeito de olhar é o contrário. Quando eu pedi para acompanhar as execuções, o próprio Claude me explicou como ele funciona:
- ⚙️ O script olha: em vez de olhar ele mesmo, o Claude escreve um script pequeno, que fica rodando e consultando o endereço que interessa, de tempos em tempos.
- ⚙️ A sessão dorme: enquanto o script roda, a sessão do Claude fica parada. Não tem turno, não tem releitura, não tem token.
- 🤖 A IA acorda: quando o script vê um resultado diferente do esperado, uma execução que terminou, uma que falhou, uma que travou, ele acorda o Claude. Aí sim a IA entra, com algo para decidir.
É a regra das 20h17, só que do lado de fora da fábrica. Quem fica de olho é código, sem IA.
Eu passei a usar muito esse modo à noite, para acompanhar as execuções do projeto. Deixava o Monitor rodando, ia dormir, e o Claude só acordava quando havia o que olhar.
O que eu levo disso
A IA não sabe que está gastando enquanto espera. Para ela, consultar mais uma vez é só mais um passo razoável. Quem tem que saber é o desenho do fluxo.
Hoje, quando eu monto uma etapa nova, faço uma pergunta antes de qualquer outra: tem alguma espera aqui dentro? Se tem, ela vai para o motor. A IA fica com o antes e o depois da espera, nunca com a espera em si.
E a regra que não muda continua de pé. O motor espera, desiste e chama, mas não aprova nada no meu lugar. O pedido bloqueado daquela tarde estava esperando uma permissão minha, e o certo era continuar esperando por mim. O errado era pagar uma IA para ficar perguntando.
O próximo passo
A espera era só metade do problema daquela terça. Mais tarde, no mesmo dia, cinco execuções rodaram em paralelo, e quatro delas falharam na hora de juntar o código. Não havia contradição nenhuma entre elas. Elas só tinham acrescentado uma linha no fim do mesmo arquivo.
No próximo capítulo, O git foi feito para humanos (capítulo 6), conto essa noite e por que, com várias IAs trabalhando ao mesmo tempo, até o formato de um arquivo vira decisão de arquitetura.