⏱️ 10 min de leitura
No capítulo anterior, O token mais caro é o de uma IA esperando (capítulo 5), contei a execução mais cara do projeto, que não entregou nada, e a regra que nasceu dela: esperar é trabalho de código.
No capítulo 1, Escala 6x1? Aqui é 24x7, eu deixei uma noite pela metade. Era terça, e eu coloquei cinco tarefas para rodar ao mesmo tempo. Quatro travaram no último passo. Escrevi que aquela noite tinha me ensinado uma lição, paralelismo é barato para começar e caro para terminar, e que contaria a história aqui.
Este capítulo é sobre essa noite e sobre o que veio depois: por que uma ferramenta pensada para pessoas atrapalha quando quem escreve são várias IAs, e por que, com agentes em paralelo, até o formato de um arquivo vira decisão de arquitetura.
20h33: cinco agentes, um arquivo
Às 20h33 daquela terça, 29 de setembro, a primeira das cinco execuções começou. Cada agente tinha a sua cópia isolada do projeto e não via o trabalho dos outros. Desenvolveram, testaram e revisaram sem esbarrar em ninguém.
O problema apareceu no fim. Naquela época, cada tarefa terminava abrindo um pedido de integração no GitHub, o PR: um pedido para juntar o código novo à main, a versão oficial do projeto. Às 22h11, o placar era de quatro falhas em cinco. Todas no mesmo passo, por conflito.
Conflito, no git, é quando duas mudanças mexem no mesmo trecho de um arquivo e ele não sabe qual vale. Uma pessoa precisa olhar e decidir. Ou, no meu caso, um agente.
Antes de seguir, uma legenda para o resto do capítulo:
- ⚙️ Motor: o orquestrador da fábrica, um programa comum, sem IA, que faz sempre a mesma coisa do mesmo jeito.
- 🤖 Agente: uma IA fazendo o trabalho.
Resolver aqueles conflitos um por um teria virado uma cascata. Imagine cinco tarefas prontas, esperando para entrar na main:
- ⚙️ Juntar a primeira: a primeira tarefa entra, e a main muda.
- 🤖 Refazer as outras: as quatro que sobraram já não se encaixam na main nova. O desenvolvedor é chamado de novo em cada uma, e depois o teste e a revisão.
- ⚙️ Juntar a segunda: uma das quatro entra, e as três restantes dão conflito outra vez. E assim por diante.
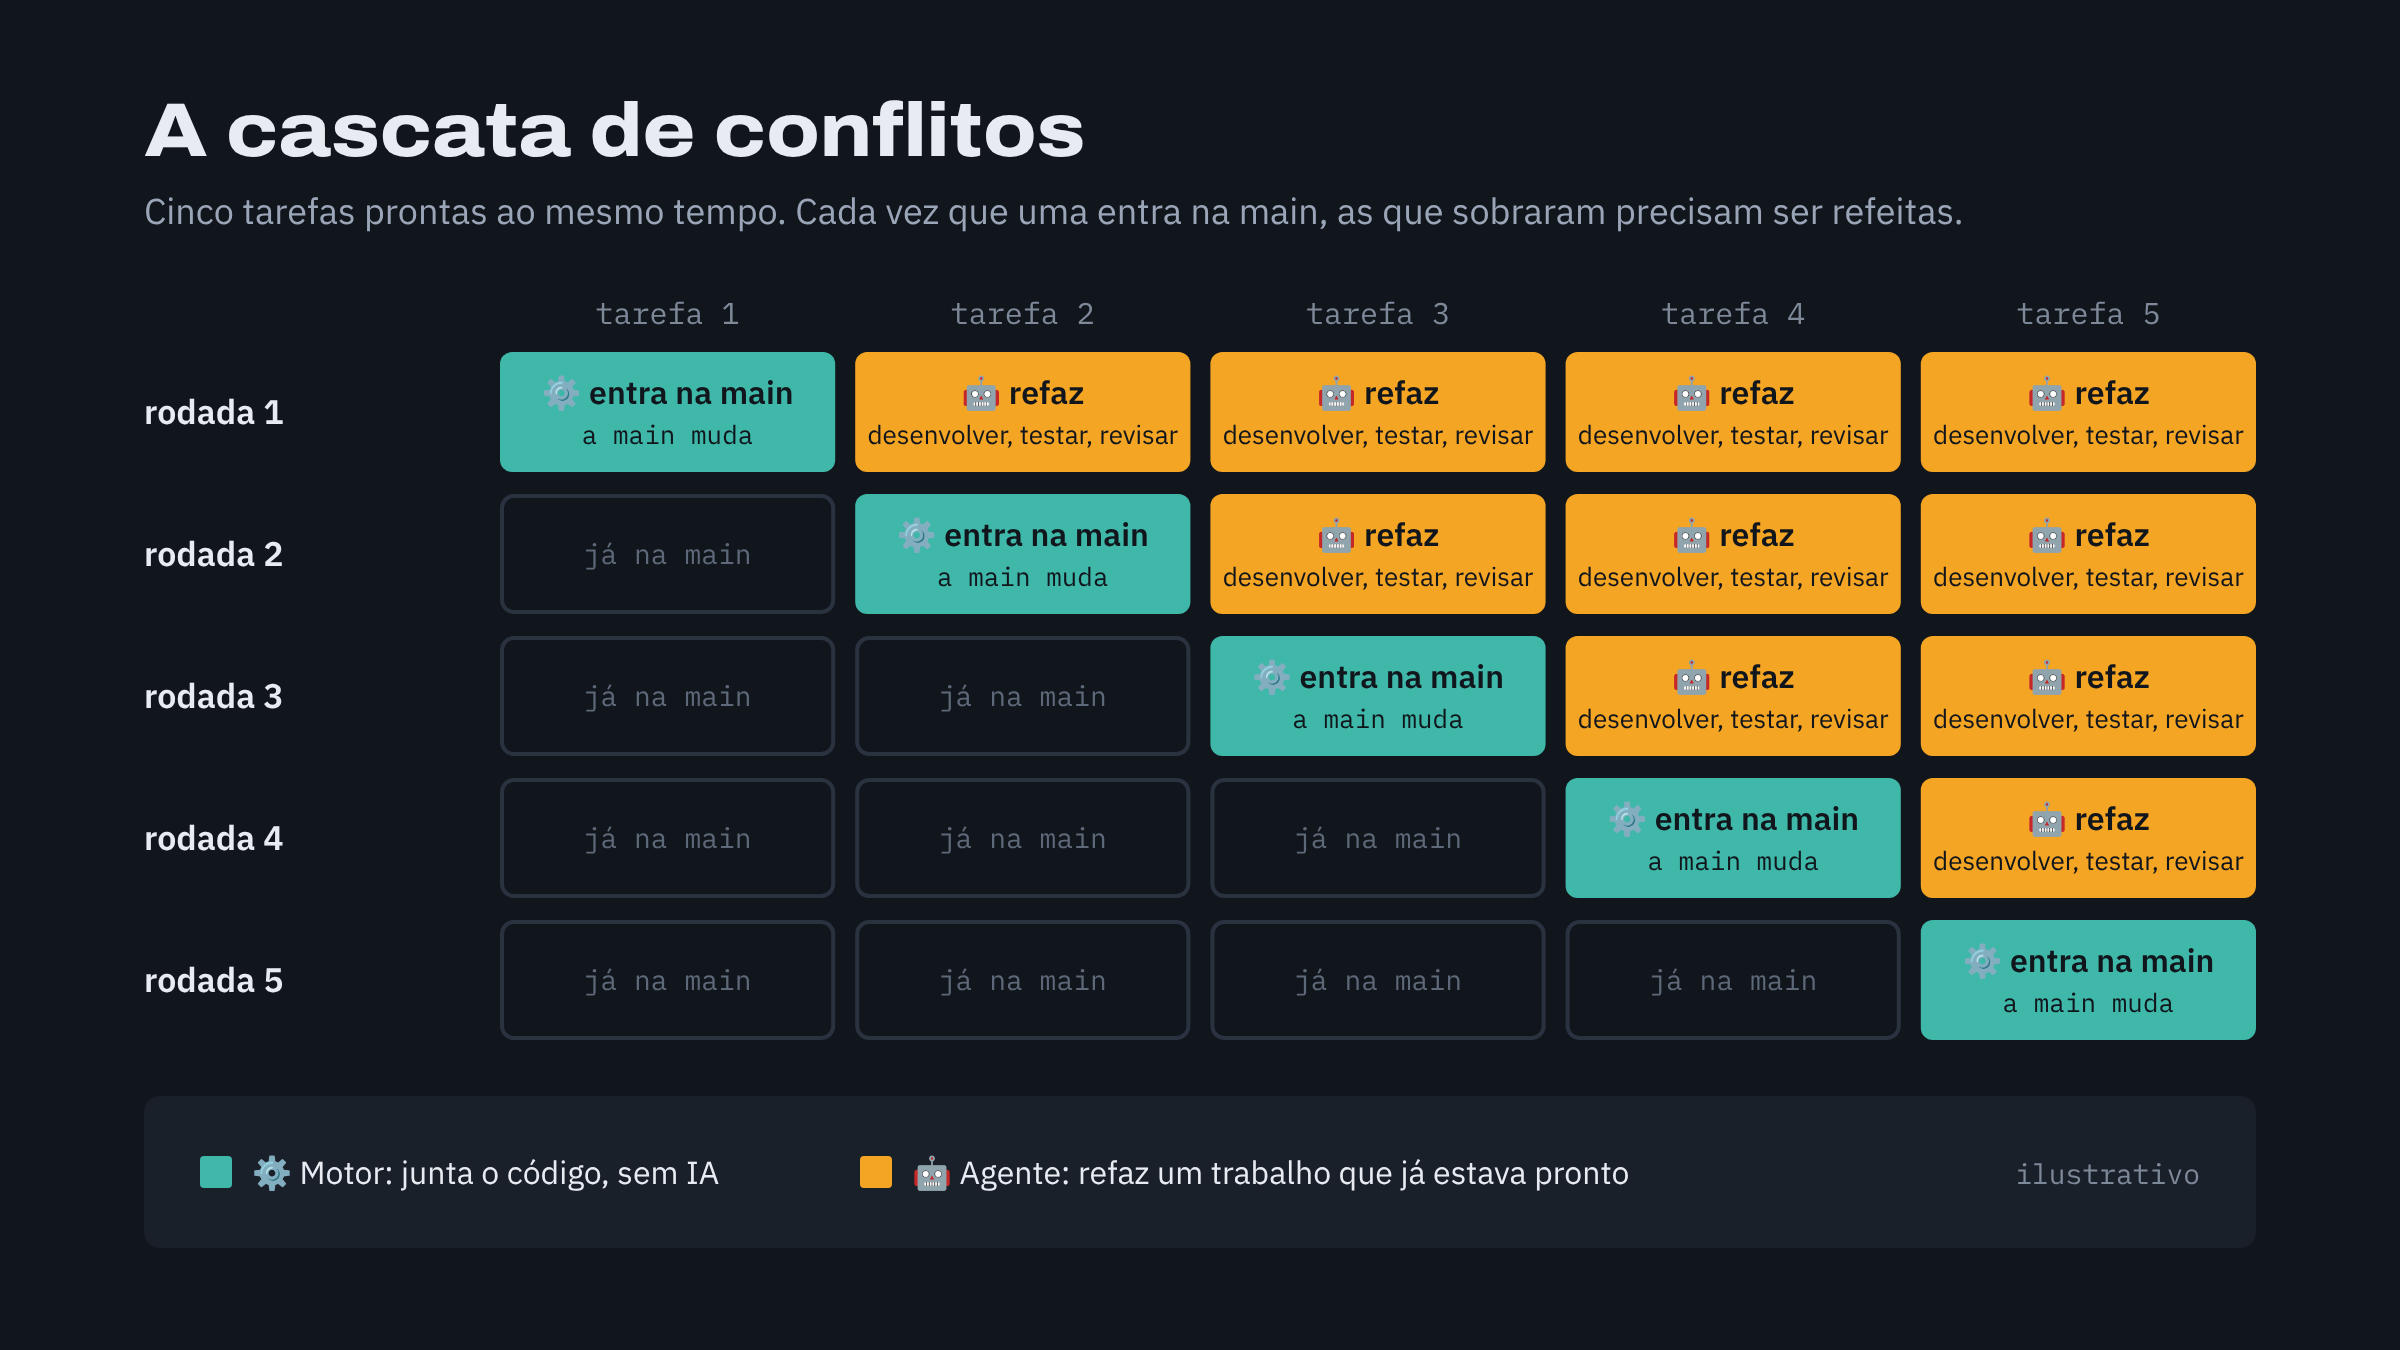
Cada volta da cascata paga de novo desenvolvimento, teste e revisão de um trabalho que já estava pronto. E, com o GitHub no meio, cada volta também rodava de novo a integração contínua.
Barato para começar, caro para terminar
A primeira resposta veio na mesma noite. Às 23h nasceu um fluxo que junta o código no meu próprio computador, sem passar pelo GitHub a cada tarefa. A integração contínua saiu do ciclo curto, e a taxa de sucesso das execuções saltou de cerca de metade para nove em cada dez. Enviar para o GitHub virou uma decisão minha, em lote.
Só que o conflito não sumiu. Ele mudou de forma.
Antes, a execução com conflito falhava, e o retrabalho virava uma execução nova. Com a junção local, ela não falhava mais: chamava um passo para resolver o conflito, com o desenvolvedor e o revisor de volta em cena. A falha virou uma resolução cara. Nesse período, as execuções com conflito ficaram com quase um terço do custo de todas as execuções.
O que mudou o jogo foi o Product Owner de IA, o PO que apresentei no capítulo 2. Ele lê o código, junta as tarefas que mexem nos mesmos arquivos em uma execução só e coloca em etapas diferentes os grupos que iriam brigar. A resolução de conflito saiu do momento de juntar o código e foi para o momento do plano.
Comparando os três jeitos de trabalhar:
- PRs em paralelo no GitHub: cerca de uma execução em cada cinco com conflito, e todas essas falharam.
- Junção local, sem o PO: a mesma proporção de conflitos, nenhuma falha, e quase um terço do custo indo para as execuções com conflito.
- Junção local, com o PO: cerca de uma execução em cada dez com conflito, e menos de um quinto do custo indo para elas.
Uma coisa que eu nunca tinha visto em um time humano: um PO de carne e osso conhece o produto, mas não sabe quais arquivos cada tarefa vai alterar. A IA no papel de PO sabe, porque consegue ler o código antes de planejar.
O git compara linhas
Mesmo com o PO, sobrava uma pergunta: por que tarefas que não tinham nada a ver uma com a outra davam conflito? Porque o git compara linhas de texto e foi feito para pessoas, que mexem em poucas linhas por vez e conversam antes de mexer no mesmo arquivo, enquanto cinco agentes em paralelo acrescentam cada um a sua tela, a sua rota e o seu estilo, todos no mesmo lugar.
Na manhã seguinte à noite das cinco execuções, as correções foram todas de formato, sem mudar o comportamento do app: o mesmo jeito de marcar o fim de linha em todos os arquivos, listas com uma entrada por linha e em ordem alfabética, e as tabelas da documentação geradas automaticamente. Os slides mostram o caso que resume tudo, uma linha que carregava vários módulos, e as saídas, da mais simples à que a fábrica adotou depois:
Com vários agentes em paralelo, o formato dos arquivos passa a ser uma decisão de arquitetura.
Onde os conflitos moram
O formato resolveu os conflitos mais bobos. Mas eles continuavam aparecendo, e sempre nos mesmos arquivos.
Quando a IA contou, entre as 35 execuções da fábrica que tinham entregado código, quantas tinham mexido em cada arquivo, o desenho ficou claro. Metade dos arquivos tinha sido tocada por uma execução só. Já o arquivo principal das telas, o index.html, tinha sido tocado por 23 das 35.
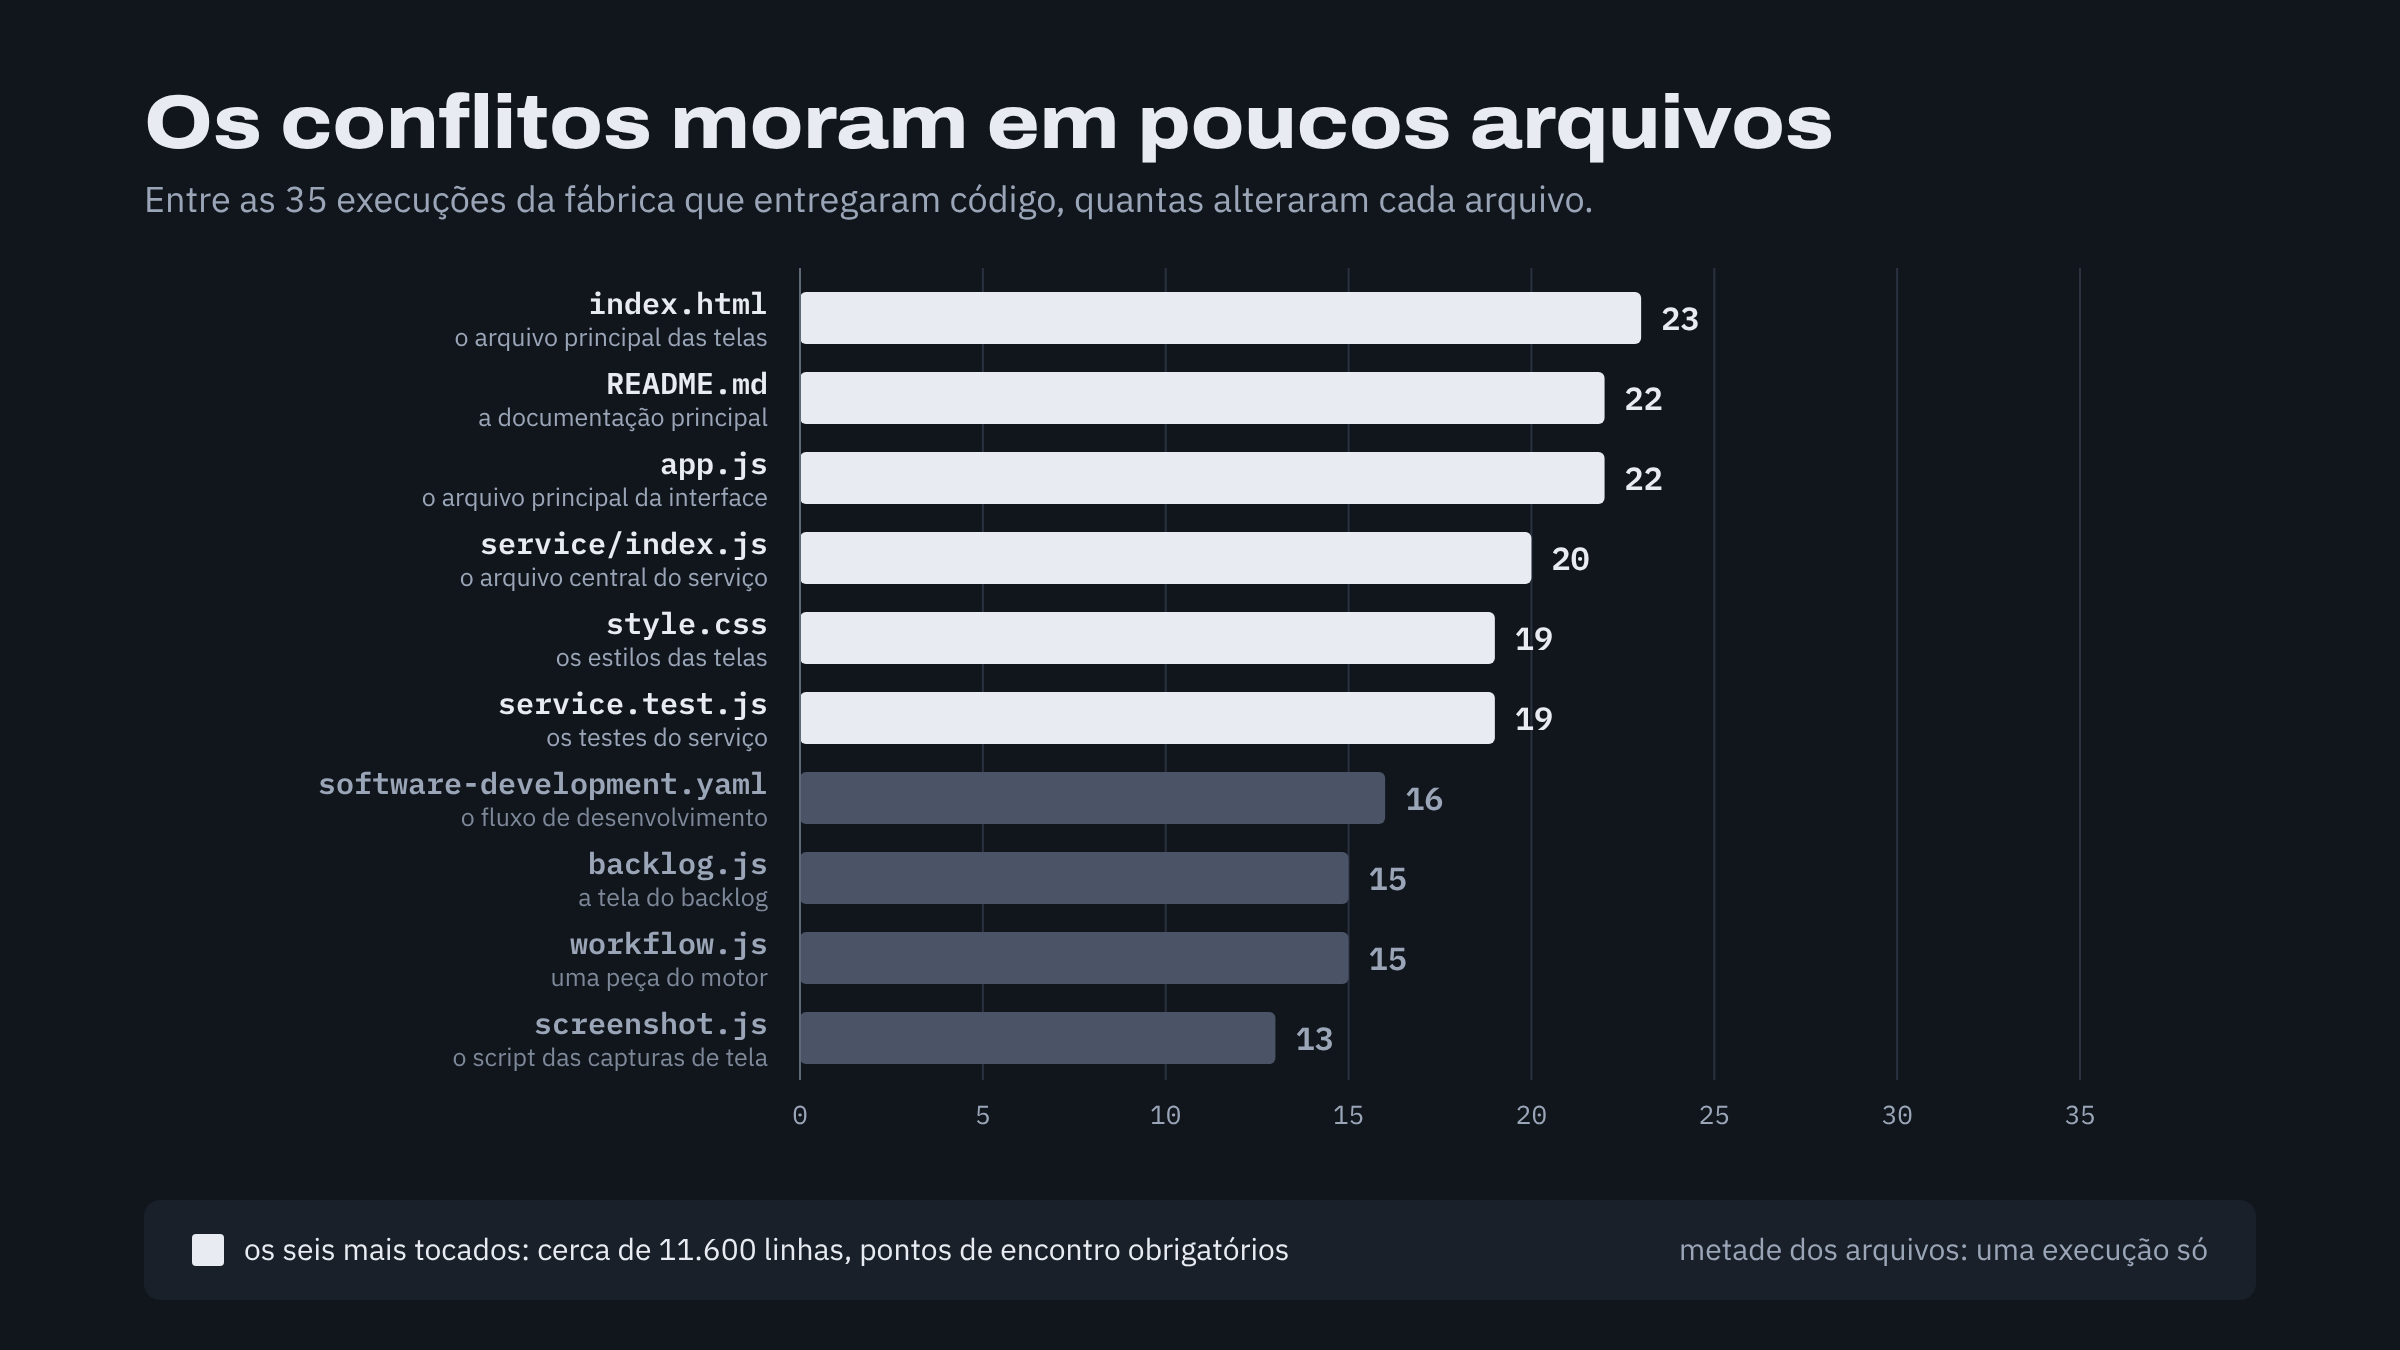
Os conflitos não se espalhavam pelo código. Eles se concentravam em poucos arquivos centrais, os que registram telas, canais, rotas e estilos. Toda funcionalidade nova precisava passar por eles. Os seis primeiros da lista somavam cerca de 11.600 linhas e funcionavam como pontos de encontro obrigatórios.
Uma arquitetura organizada para pessoas faz exatamente isso. Um arquivo central, que registra tudo, é ótimo para quem lê: está tudo em um lugar só. Para cinco agentes escrevendo ao mesmo tempo, é uma porta estreita.
1º de outubro: a arquitetura reescrita para não conflitar
No fim da tarde de quinta, 1º de outubro, a fábrica rodou um épico, um conjunto de tarefas com um objetivo só: reorganizar o próprio código para não conflitar. Nenhuma mudança de comportamento, só de formato. Foi a reorganização que contei de passagem no capítulo 1, antes da segunda noite.
O princípio era simples: uma funcionalidade nova acrescenta arquivos, não edita arquivos compartilhados. Na prática:
- Uma pasta por tela: dez telas saíram do arquivo central e ganharam arquivos próprios.
- Listas geradas: a lista do que o
index.htmlcarrega passou a ser montada automaticamente, a partir dos arquivos que existem. - Estrutura mínima no centro: o arquivo principal da interface ficou só com o esqueleto do app.
Os arquivos que todo mundo tocava encolheram:
- O arquivo principal da interface (
app.js): de 3.932 linhas para 953. - O
index.html: de 1.383 para 334. - O arquivo central do serviço: de 1.767 para 115.
- O arquivo gigante de testes do serviço: dividido por área.
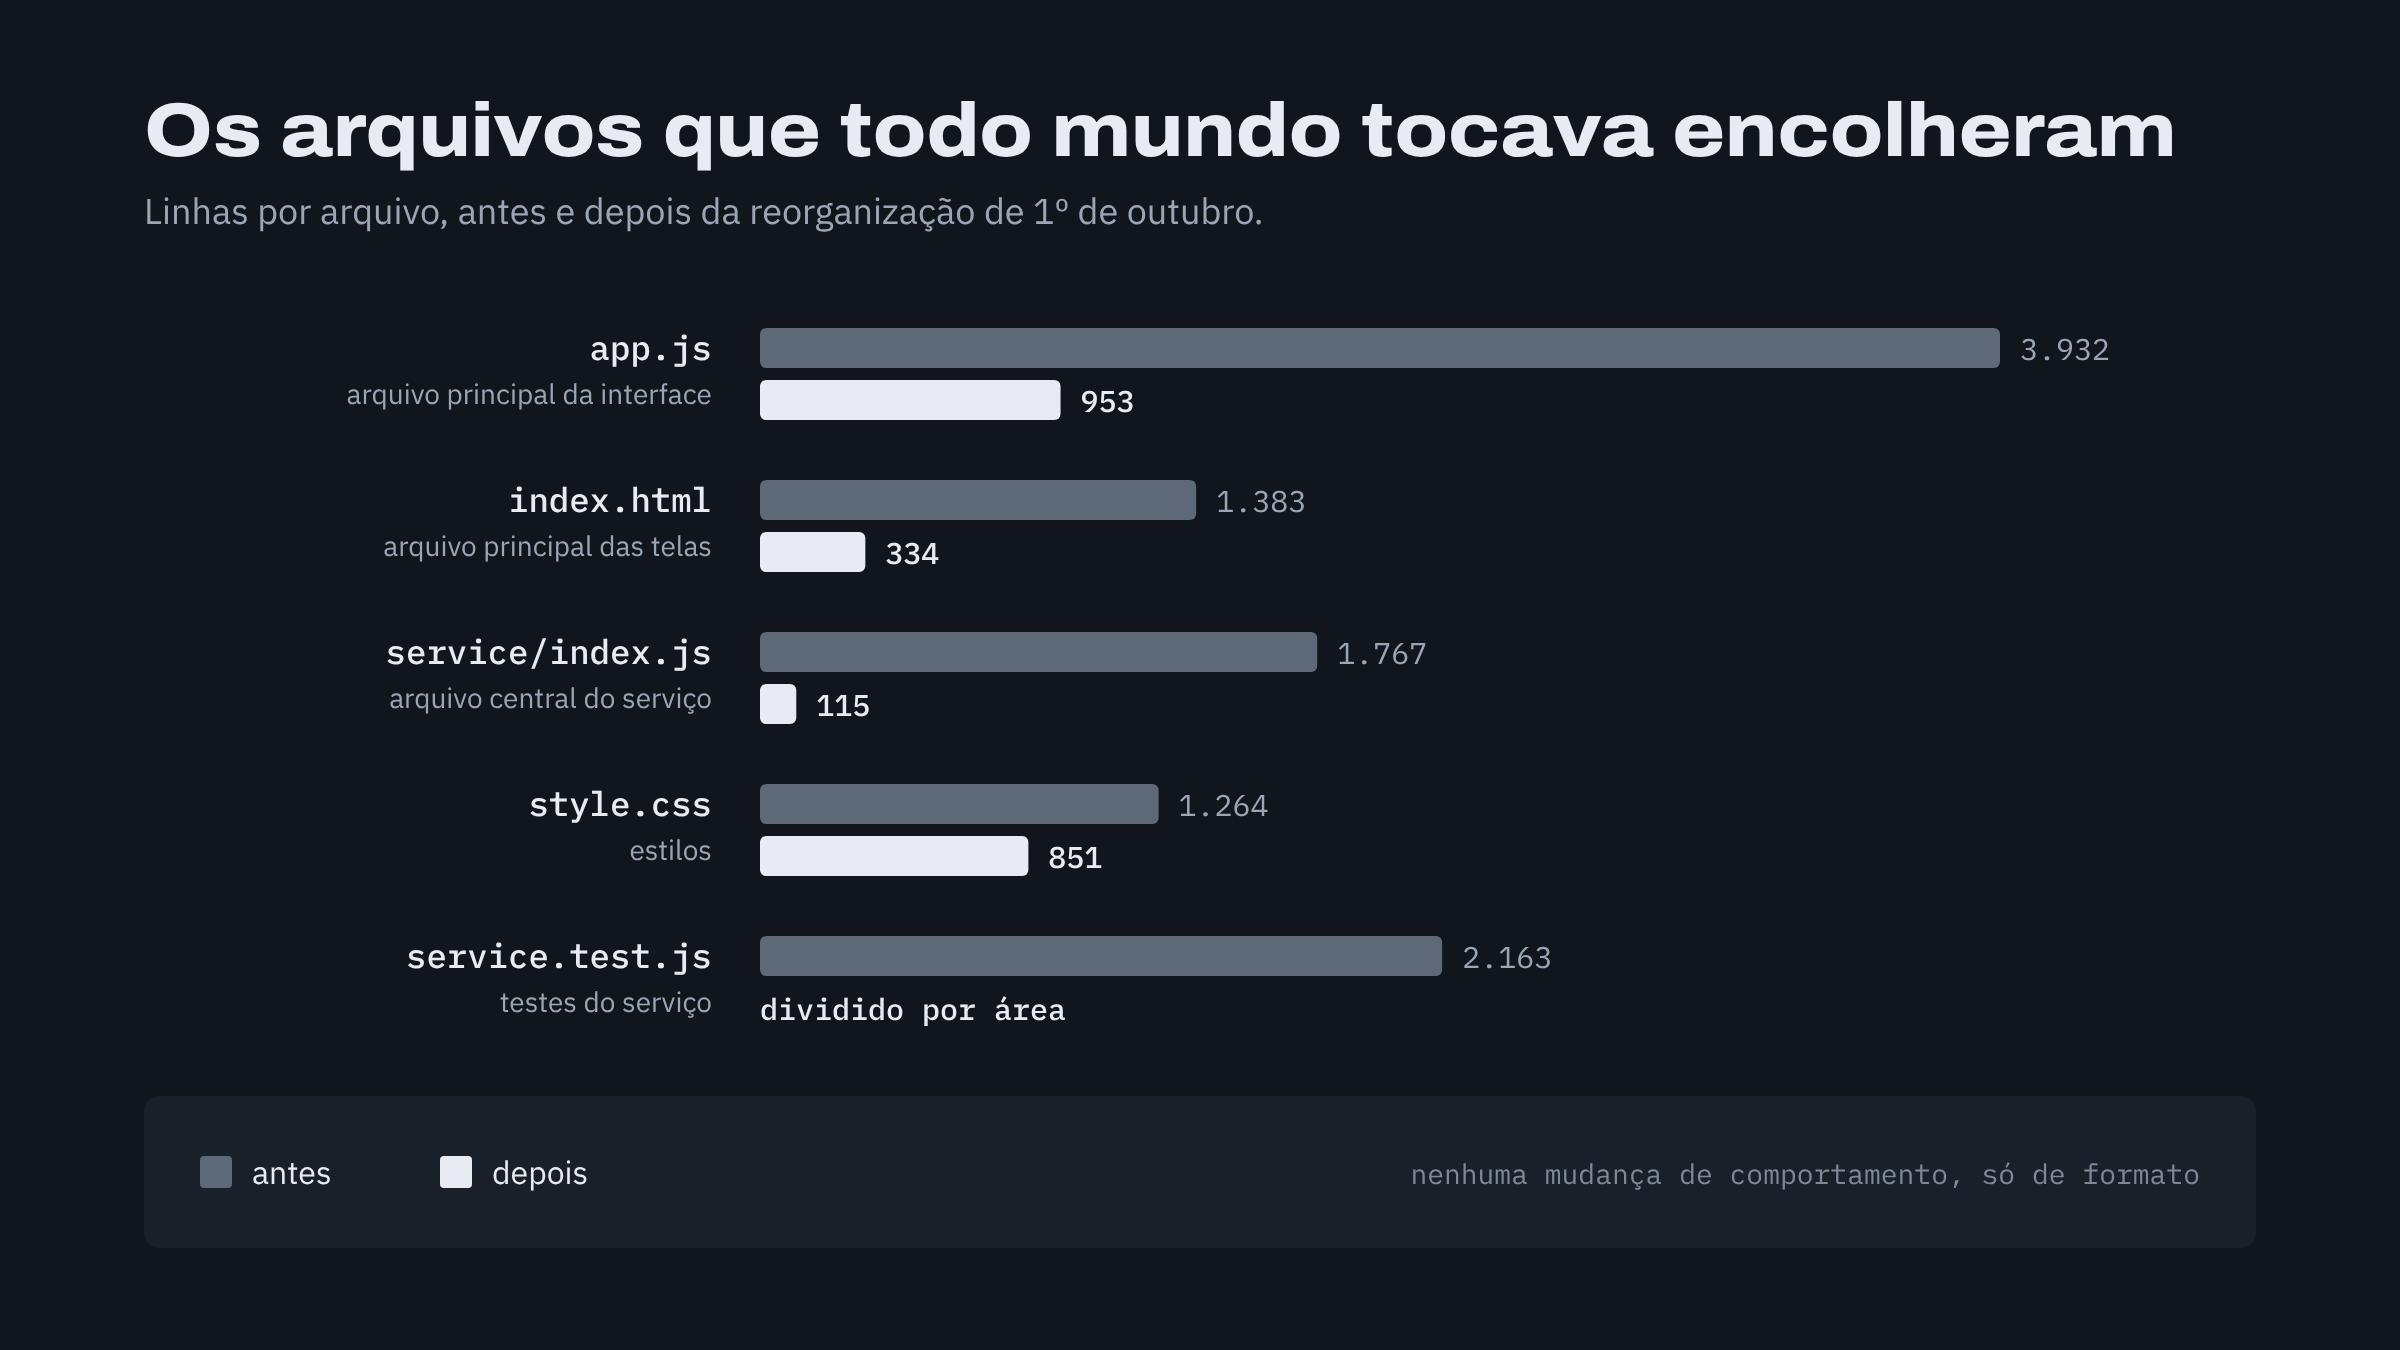
O resultado é uma arquitetura que não é comum. Para uma pessoa, ela é pior de ler: o que antes estava em um arquivo agora está espalhado em dezenas. Mas o objetivo era outro. Era deixar várias IAs trabalharem ao mesmo tempo sem esbarrar umas nas outras. O próprio épico rodou em seis execuções, sem nenhum conflito.
A segunda noite, medida
A segunda noite, a que eu contei no capítulo 1, foi a primeira depois da reorganização. Com a porta mais larga, o PO colocou até cinco execuções ao mesmo tempo, contra duas na primeira noite. Foram cerca de 25 tarefas. Houve quatro conflitos, e os quatro foram resolvidos sem mim, sem nenhuma falha na hora de juntar o código.
Os números por arquivo mostraram que a reorganização tinha funcionado. Antes, um commit em cada três mexia no app.js ou no arquivo central do serviço. Naquela noite, foi um em cada oito no app.js e quase nenhum no serviço.
Mais tarefas por hora, porém, não quis dizer tarefa mais barata. A fábrica entregou quase metade a mais de tarefas por hora de relógio, e cada mil linhas passaram a consumir quase metade a mais de tokens. A reorganização tirou o gargalo da hora de juntar o código, e o custo a mais veio de outro lugar, dos turnos do agente de testes. Essa conta está no capítulo 4, O gargalo não é o código, é o teste.
E novos pontos de encontro já apareciam: a documentação principal do projeto e o script que tira as capturas de tela. Por isso nasceu o mapa de conflitos. Ele é calculado pelo motor ⚙️, sem chamar nenhuma IA, a partir do histórico das execuções: quais arquivos e quais linhas mais execuções tocam. O PO consulta o mapa para montar as etapas e propõe quebrar os pontos quentes antes que eles virem conflito.
O que o formato não resolve
Nem todo conflito é de formato. Quando duas tarefas mudam o mesmo comportamento, por exemplo duas regras diferentes para o que acontece com uma tarefa atrasada, o conflito é real. Nenhuma ferramenta vai decidir qual regra vale.
Quando fui atrás de saídas além do git, encontrei três níveis:
- Formato do repositório: um arquivo por coisa, listas com uma entrada por linha e tabelas geradas. Elimina a maioria dos conflitos de texto, e foi por aqui que eu comecei.
- Junção que entende código: ferramentas como o Mergiraf comparam a estrutura do código, e não as linhas, e funcionam dentro do próprio git.
- Outro modelo de versionamento: o Jujutsu, compatível com o git, e o Pijul tratam o conflito como um estado que pode ser guardado e resolvido depois, sem travar o fluxo. Combina melhor com muitos agentes em paralelo.
Nenhum dos três resolve o conflito de comportamento. Para esse, a resposta continua sendo planejar antes. O PO prevê os arquivos que cada grupo vai tocar, aponta onde pode haver conflito e separa os grupos em etapas, como um gerenciador de travas de um banco de dados decide quem escreve primeiro. Mesmo assim, o conflito não chegou a zero: com o PO, 3 de 27 execuções ainda precisaram resolver um.
Quando escrevi isso, a IA concordou com o centro e ajustou a borda. Talvez a fronteira não seja a pessoa, e sim a área do código: se cada pessoa for dona de um módulo, com o seu PO e o seu roadmap, várias ainda cabem no mesmo repositório, desde que as áreas não se cruzem. Um repositório por pessoa seria o caso extremo dessa mesma ideia.
Uma coisa não mudou com nada disso. O código é juntado no meu computador, mas mandar para o GitHub continua sendo uma decisão minha, e a automação não atravessa uma aprovação humana.
O próximo passo
Planejar antes resolveu o conflito. O PO prevê os arquivos, separa as etapas, e a noite roda sem esbarrar. Mas nem tudo vale a pena prever. Na manhã depois da primeira noite, eu acordei com telas prontas que ninguém tinha desenhado antes, e percebi que era mais fácil julgar uma tela pronta do que descrever uma que não existia.
No próximo capítulo, Refinar antes ou reagir depois? (capítulo 7), conto quando vale planejar cada detalhe e quando sai mais barato deixar a fábrica entregar e reagir ao que ficou pronto.